EvolveDirector EvolveDirector是一个由阿里巴巴与南洋理工大学合作开发的文本到图像生成框架,通过与高级模型API交互获取数据对,结合预训练的视觉语言模型(VLMs)动态优化训练集,大幅降低数据量和训练成本。该框架支持多模型学习、动态数据集管理及在线训练,显著提升了生成图像的质量和多样性,广泛应用于内容创作、媒体娱乐、广告营销、教育科研等多个领域。 AI项目与工具 2025年06月12日 17 点赞 0 评论 770 浏览
DiffSensei DiffSensei是一款由北京大学、上海AI实验室及南洋理工大学联合开发的漫画生成框架,它结合了基于扩散的图像生成技术和多模态大型语言模型(MLLM)。该工具能够根据用户提供的文本提示和角色图像,生成具有高精度和视觉吸引力的黑白漫画面板,支持多角色场景下的互动与布局调整。其核心技术包括掩码交叉注意力机制、对话布局编码以及MLLM作为特征适配器等,广泛应用于漫画创作、个性化内容生成、教育和培训等领 AI项目与工具 2025年06月12日 47 点赞 0 评论 789 浏览
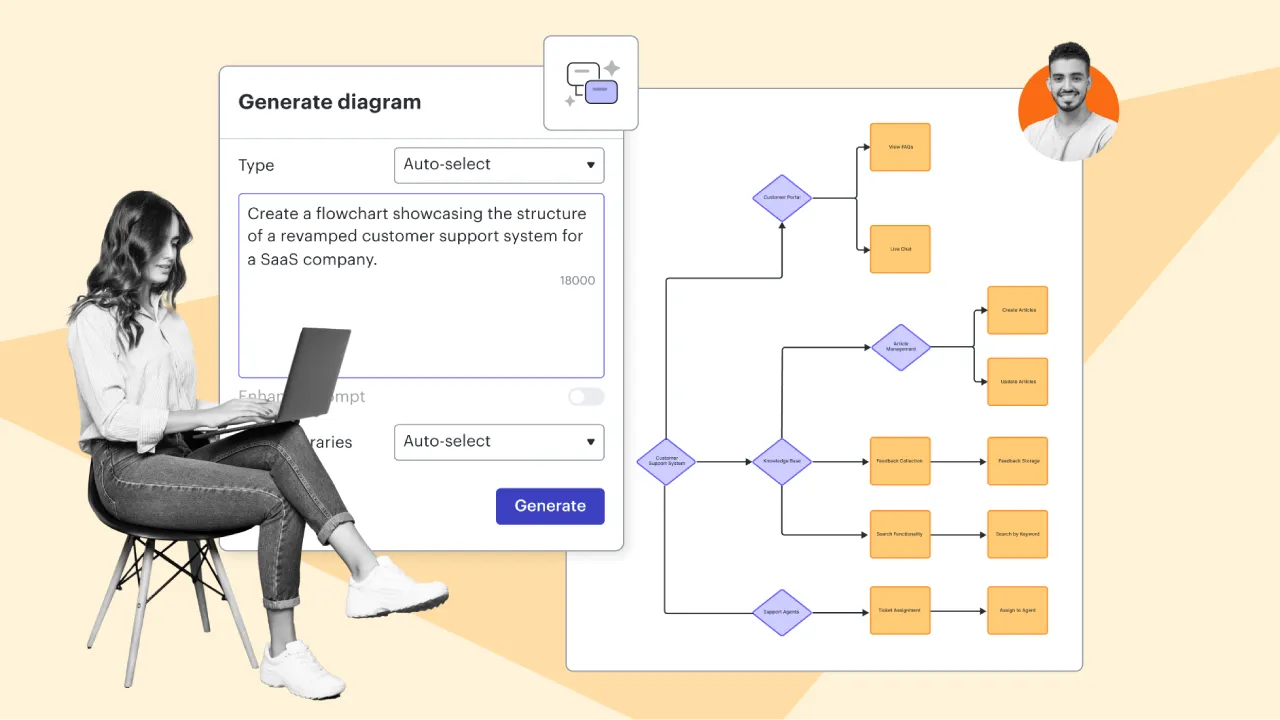
Lucidchart 由Lucid Software开发的在线图表制作和可视化工具,支持创建流程图、组织结构图、思维导图、UML、ERD、BPMN等多种图表类型,并提供实时协作功能。 教育学习 2025年06月05日 65 点赞 0 评论 792 浏览
TokenFD TokenFD是由上海交通大学与美团联合开发的细粒度图文对齐基础模型,专为文档理解任务设计。通过图像与语言Token的统一特征空间对齐,支持Token级图文交互,提升了多模态任务性能。其基于自研的TokenIT数据集进行训练,涵盖2000万张图像和18亿高质量Token-Mask对,覆盖多种文本图像类型。TokenFD可用于文档处理、图像审查、文字检索及大模型知识增强等多个领域,具有广泛的适用性和 AI项目与工具 2025年06月12日 90 点赞 0 评论 794 浏览
ChildMandarin ChildMandarin是由智源研究院与南开大学合作开发的3-5岁儿童普通话语音数据集,包含41.25小时高质量语音,覆盖全国22个省市。数据通过家长引导式对话采集,保证自然真实。该数据集支持语音识别、说话人验证和语言研究,适用于儿童语言学习、教育系统、智能玩具和语音助手优化等领域,为儿童语音技术研究提供重要资源。 AI项目与工具 2025年06月12日 28 点赞 0 评论 796 浏览
StableCode StableCode,一个用于代码生成的大语言模型。StableCode 基于 GPT-NeoX 构建,该模型通过指令模型和具体应用示例进行改进,用于解决复杂的编程任务。 Ai编程建站 2025年06月05日 12 点赞 0 评论 796 浏览
MMRole MMRole是一个由中国人民大学高瓴人工智能学院研究团队开发的多模态角色扮演智能体(MRPA)框架。该框架通过整合图像和文本,使智能体能够以特定角色进行更为自然和沉浸式的对话。MMRole框架包括一个大规模、高质量的多模态数据集和一个全面的评估方法,用于开发和评估MRPAs的性能。该框架为创建能够理解和生成与图像相关对话内容的智能体提供了新的可能,并扩展了其在教育、娱乐、客户服务、社交模拟和内容创 AI项目与工具 2025年06月12日 28 点赞 0 评论 804 浏览
Emotion Emotion-LLaMA是一款基于多模态输入的情绪识别与推理模型,结合音频、视觉和文本信息,提升情感理解的准确性与可解释性。模型采用改进版LLaMA架构,通过指令调整增强情感处理能力,并依托自建的MERR数据集进行训练与验证。在多个挑战赛中表现优异,适用于人机交互、教育、心理健康、客户服务等领域,具有广泛的应用前景。 AI项目与工具 2025年06月12日 85 点赞 0 评论 806 浏览
OmniAlign OmniAlign-V是由多所高校联合开发的多模态大语言模型对齐数据集,包含约20万个多模态样本,涵盖自然图像和信息图表。其核心功能包括提供高质量训练数据、提升模型的开放式问答能力、增强推理与创造力,并支持模型持续优化。数据集通过图像筛选、任务设计及后处理优化确保数据质量,适用于多模态对话系统、图像辅助问答、创意生成等多个应用场景。 AI项目与工具 2025年06月12日 99 点赞 0 评论 808 浏览