TokenFD TokenFD是由上海交通大学与美团联合开发的细粒度图文对齐基础模型,专为文档理解任务设计。通过图像与语言Token的统一特征空间对齐,支持Token级图文交互,提升了多模态任务性能。其基于自研的TokenIT数据集进行训练,涵盖2000万张图像和18亿高质量Token-Mask对,覆盖多种文本图像类型。TokenFD可用于文档处理、图像审查、文字检索及大模型知识增强等多个领域,具有广泛的适用性和 AI项目与工具 2025年06月12日 90 点赞 0 评论 794 浏览
Seaweed Seaweed-7B 是一款由字节跳动开发的视频生成模型,拥有约 70 亿参数,支持从文本、图像或音频生成高质量视频。具备文本到视频、图像到视频、音频驱动生成、长镜头、连贯叙事、实时生成等功能,适用于内容创作、教育、广告等多个领域。采用变分自编码器和扩散变换器技术,结合多阶段训练与优化策略,提升生成效率与质量,兼顾性能与成本效益。 AI项目与工具 2025年06月11日 80 点赞 0 评论 795 浏览
moonshot moonshot-v1-vision-preview 是一款由月之暗面开发的多模态图像理解模型,具备精准的图像识别、OCR 文字识别和数据解析能力。支持 API 集成,适用于内容审核、文档处理、医学分析、智能交互等多个领域。模型可识别复杂图像细节、分析图表数据,并从美学角度进行图像评价,适合需要高效图像处理和智能交互的应用场景。 AI项目与工具 2025年06月12日 52 点赞 0 评论 796 浏览
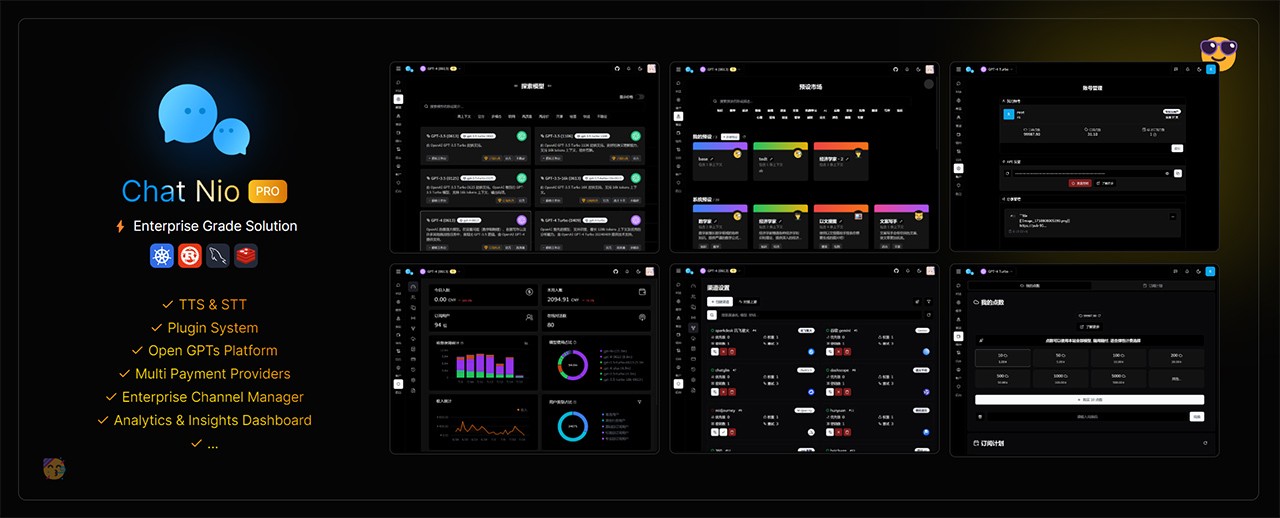
ChatNio 一个集合了各种流行的模型和服务的一站式平台,提供包括 OpenAI、Midjourney、Claude、讯飞星火、Stable Diffusion、DALL·E 等一站式的解决方案 Ai开源项目 2025年06月05日 56 点赞 0 评论 804 浏览
Emotion Emotion-LLaMA是一款基于多模态输入的情绪识别与推理模型,结合音频、视觉和文本信息,提升情感理解的准确性与可解释性。模型采用改进版LLaMA架构,通过指令调整增强情感处理能力,并依托自建的MERR数据集进行训练与验证。在多个挑战赛中表现优异,适用于人机交互、教育、心理健康、客户服务等领域,具有广泛的应用前景。 AI项目与工具 2025年06月12日 85 点赞 0 评论 805 浏览
Titans Titans是谷歌推出的新型神经网络架构,突破了传统Transformer在处理长序列数据时的限制。其核心是神经长期记忆模块,可模拟人脑记忆机制,提升对关键信息的存储与提取能力。Titans支持多种任务,包括语言建模、常识推理和时间序列预测,尤其在处理超长上下文时表现优异。该架构具备并行计算能力,提高了训练效率,适用于文本生成、生物信息学、视频音乐处理等多个领域。 AI项目与工具 2025年06月12日 27 点赞 0 评论 809 浏览
AIMv2 AIMv2是苹果公司开发的开源多模态自回归预训练视觉模型,通过图像与文本的深度融合提升视觉理解能力。其采用图像块与子词标记拼接的方式进行自回归预训练,支持多种参数规模,适用于不同设备。具备视觉问答、指代表达理解、图像字幕生成、多媒体检索等功能,并可无缝集成到大型语言模型中。模型在多个视觉任务中表现优异,具备良好的可扩展性和零样本适应能力。 AI项目与工具 2025年06月12日 48 点赞 0 评论 811 浏览
Sa2VA Sa2VA是由字节跳动联合多所高校开发的多模态大语言模型,结合SAM2与LLaVA技术,实现对图像和视频的密集、细粒度理解。它支持指代分割、视觉对话、视觉提示理解等多种任务,具备零样本推理能力和复杂场景下的高精度分割效果。适用于视频编辑、智能监控、机器人交互、内容创作及自动驾驶等多个领域。 AI项目与工具 2025年06月12日 66 点赞 0 评论 811 浏览
ViLAMP ViLAMP是由蚂蚁集团与中国人民大学联合开发的视觉语言模型,专为高效处理长视频设计。采用混合精度策略,支持在单张A100 GPU上处理长达3小时的视频,提升处理效率并降低计算成本。具备长视频理解、关键信息提取、多任务处理等功能,适用于教育、监控、直播、影视制作及智能客服等场景。技术上通过差分关键帧选择与特征合并优化性能,实现精准且高效的视频分析。 AI项目与工具 2025年06月11日 37 点赞 0 评论 815 浏览
R1 R1-Onevision 是一款基于 Qwen2.5-VL 微调的开源多模态大语言模型,擅长处理图像与文本信息,具备强大的视觉推理能力。它在数学、科学、图像理解等领域表现优异,支持多模态融合与复杂逻辑推理。模型采用形式化语言和强化学习技术,提升推理准确性与可解释性,适用于科研、教育、医疗及自动驾驶等场景。 AI项目与工具 2025年06月12日 92 点赞 0 评论 815 浏览