AI模型

BioMedGPT

BioMedGPT-R1是由清华大学AI产业研究院与北京水木分子生物科技联合开发的多模态生物医药开源大模型。基于DeepSeek R1技术,实现生物模态(如分子、蛋白质)与自然语言的统一融合,支持跨模态问答与深度推理。该模型在药物分子理解、靶点挖掘等领域表现优异,适用于药物设计、临床前研究及医学文本分析等多种场景,具备较高的文本推理能力和多模态处理能力。

VARGPT

VARGPT是一款多模态大语言模型,整合了视觉理解和生成任务于统一的自回归框架中。它通过next-token和next-scale预测机制,支持文本与图像的混合输入和输出,具备高效的视觉生成能力。模型采用三阶段训练策略,提升了在视觉问答、推理及图像生成任务中的表现。适用于多模态内容创作、指令到图像合成等场景。

谷歌DeepMind推出V2A技术,可为无声视频添加逼真音效

DeepMind推出的V2A(Video-to-Audio)模型能够将视频内容与文本提示相结合,生成包含对话、音效和音乐的详细音频轨道。它不仅能够与DeepMind自身的视频生成模型Veo协同工作,还能与其他视频生成模型,如Sora、可灵或Gen 3等,进行集成,从而为视频添加戏剧性的音乐、逼真的音效或与视频中角色和情绪相匹配的对话。V2A的强大之处在于其能够为每个视频输入生成无限数量的音轨。该模

TryOnDiffusion

TryOnDiffusion就谷歌推出的一项新虚拟试穿功能,能够实现高度逼真的虚拟试穿,用户能够直观地看到不同体型的人穿着不同尺寸的衣服效果如何。

Dream

Dream-7B是由香港大学与华为诺亚方舟实验室联合开发的开源扩散模型,支持文本、数学和代码生成,具备双向上下文建模能力和灵活的生成控制。其在通用任务、数学推理和编程方面表现优异,适用于文本创作、数学求解、编程辅助及复杂任务规划等多种场景,提供高效且高质量的生成服务。

Reka Flash 3

Reka Flash 3 是一款由 Reka AI 开发的开源推理模型,拥有 21 亿参数,支持多模态输入(文本、图像、视频、音频),并可处理最长 32k 个令牌的上下文。它具备高效的推理能力和多语言支持,适用于日常对话、编码辅助、指令执行等多种场景。模型可在本地部署,支持 4 位量化以降低资源占用,适合广泛的应用需求。

Granite 4.0 Tiny Preview

Granite 4.0 Tiny Preview是IBM推出的轻量级语言模型,具备高效计算能力和紧凑结构,支持在消费级GPU上运行多个长上下文任务。采用混合Mamba-2/Transformer架构,结合高效与精准优势,支持无位置编码(NoPE)处理128K tokens上下文。内存需求降低72%,推理时仅激活1B参数,适用于边缘设备部署、长文本分析及企业级应用开发,适合资源受限环境下的AI研究与

Vidgo AI

一个多合一AI图像、音乐和视频生成器,能将文字、图片等素材变成图像、音乐和视频等多媒体内容。提供AI 图像生成、视频生成和编辑三大核心功能。

Chichi

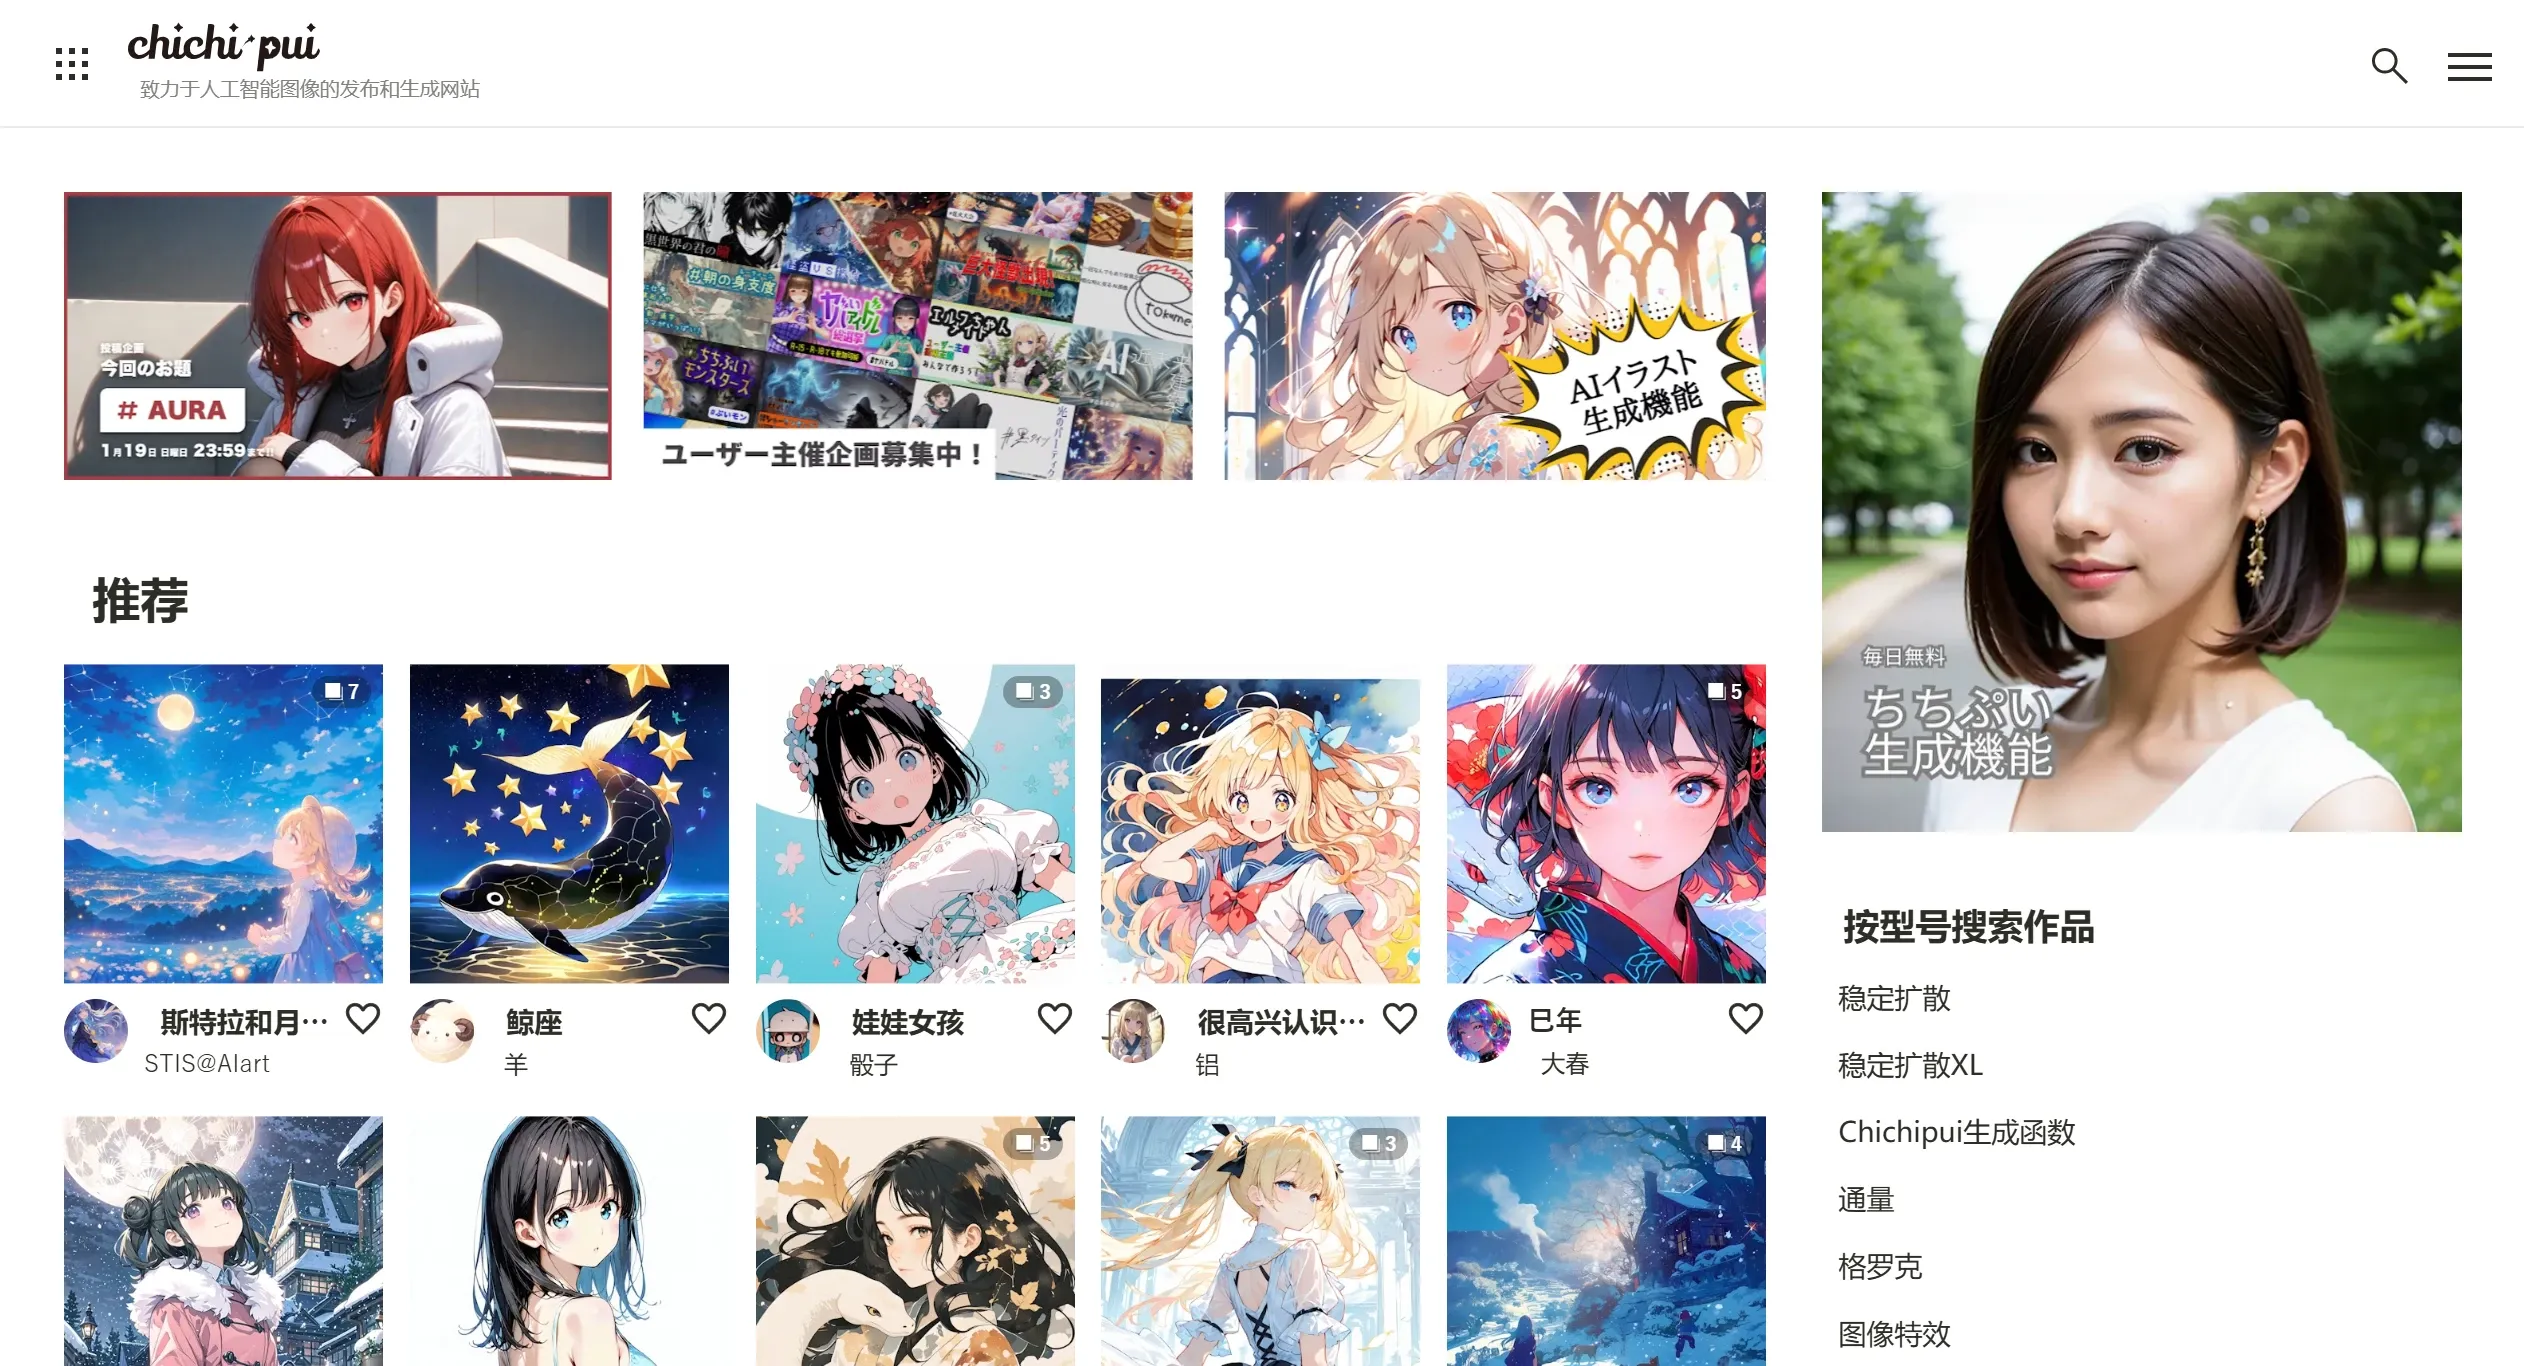
一个专注于AI生成图像的日本网站,只要针对动漫爱好者、数字艺术家和影像设计师群体,生成动漫风格的插图、写实照片以及日本流行的写真风格。

AutoTrain

AutoTrain是一款由Hugging Face开发的无代码平台,支持用户通过上传数据快速创建和部署定制化的AI模型。它涵盖多种机器学习任务,如文本分类、图像识别及表格数据分析,并提供自动化的数据预处理、分布式训练、超参数优化等功能,适用于自然语言处理、计算机视觉等多个领域。其核心优势在于简化了模型训练流程,使非技术人员也能高效构建高质量模型。 ---