MedGemma MedGemma是谷歌推出的开源AI模型,专注于医疗图像与文本分析。它包含4B参数的多模态模型和27B参数的纯文本模型。4B模型擅长解读医疗图像并生成诊断报告,27B模型则用于医疗文本理解与临床推理。支持本地运行或通过Google Cloud部署,适用于医疗诊断、患者分诊、临床决策辅助等场景,提升医疗服务效率与准确性。 AI项目与工具 2025年06月11日 81 点赞 0 评论 699 浏览
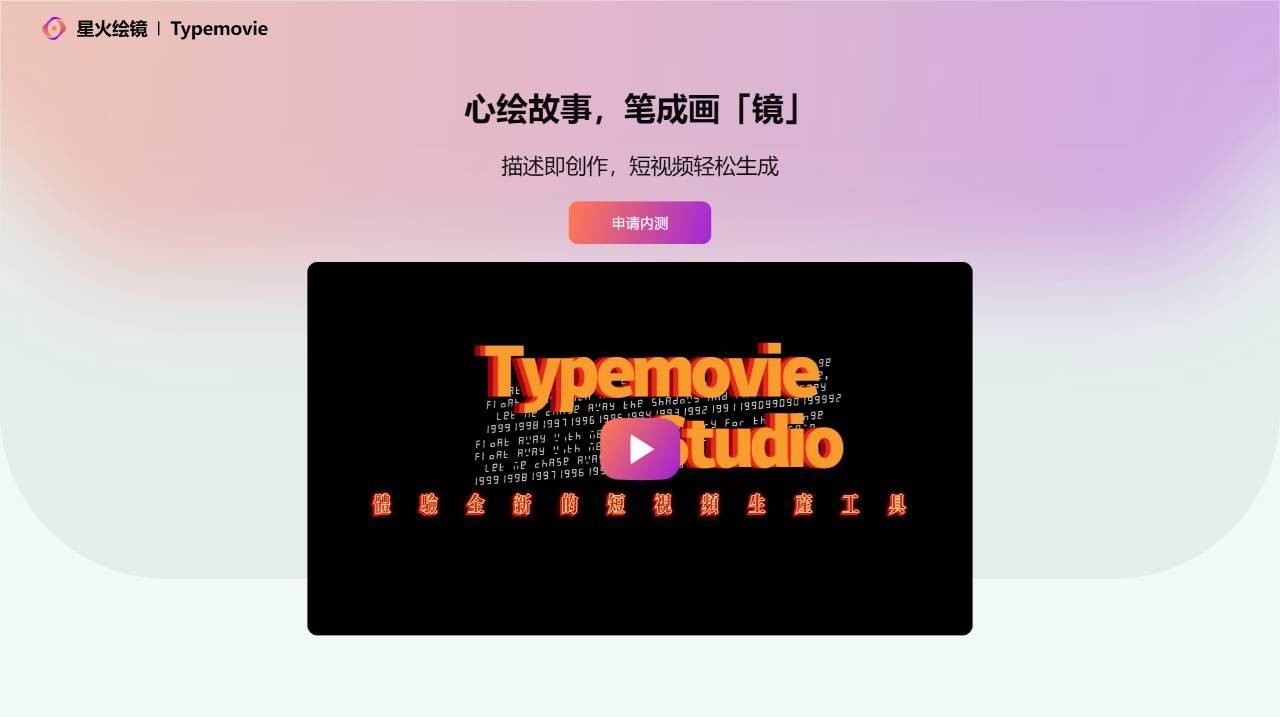
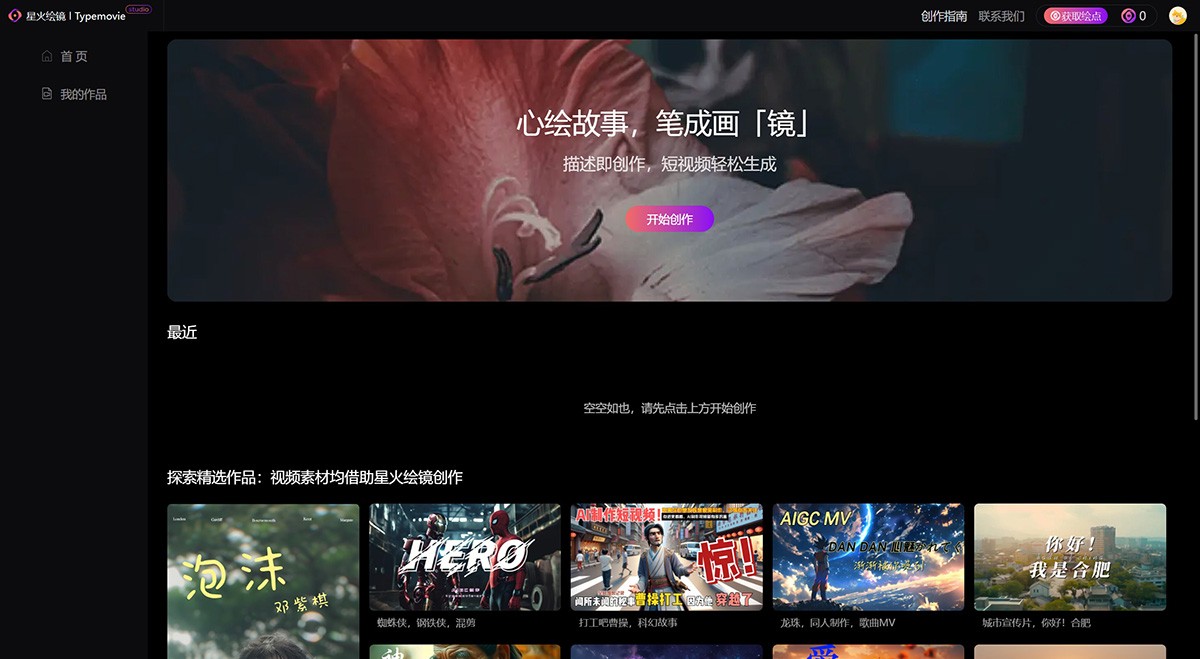
星火绘镜 一款由科大讯飞推出的AI文生视频创作平台,可以轻松地从文字描述生成短视频内容、将文本转换为视频分镜、扩展成完整的短视等。 Ai视频生成 2025年06月05日 13 点赞 0 评论 698 浏览
Versatile Versatile-OCR-Program是一款开源多模态OCR工具,支持从教育材料中提取文本、公式、表格等结构化数据,输出为JSON或Markdown格式,准确率高达90%-95%。它基于DocLayout-YOLO、Google Vision和MathPix等技术,支持多语言处理,适用于教育数据集制作、教学辅助、AI模型训练及个人学习等场景。 AI项目与工具 2025年06月11日 77 点赞 0 评论 696 浏览
ACE ACE是一款基于扩散Transformer架构的多模态图像生成与编辑工具,通过长上下文条件单元(LCU)和统一条件格式实现自然语言指令的理解与执行。它支持图像生成、编辑、多轮交互等多种任务,适用于艺术创作、媒体制作、广告设计、教育培训等多个领域,提供高效且灵活的视觉内容解决方案。 AI项目与工具 2025年06月12日 74 点赞 0 评论 696 浏览
FlexIP FlexIP 是腾讯推出的图像合成框架,支持在保持主体身份的同时进行个性化编辑。其双适配器架构分离身份保持与编辑功能,结合动态权重门控机制实现灵活控制,并通过多模态数据训练提升生成质量与稳定性,适用于艺术创作、广告设计、影视制作等多个领域。 AI项目与工具 2025年06月11日 31 点赞 0 评论 696 浏览
WeaveFox WeaveFox 是一款基于 AI 技术的前端开发平台,通过百灵多模态大模型实现从设计图到前端源代码的自动化生成,支持多端适配及多种技术栈。它不仅提高了开发效率和代码质量,还提供了灵活的二次调整功能,确保设计意图的精准还原。未来,WeaveFox 将开放更多应用场景,如快速原型开发、中后台页面构建以及移动端界面生成等。 AI项目与工具 2025年06月12日 88 点赞 0 评论 695 浏览
CLaMP 3 CLaMP 3是由清华大学朱文武教授团队开发的多模态、多语言音乐信息检索框架,支持文本、图像、音频和乐谱等多种模态之间的跨模态检索。其基于对比学习技术,将不同模态数据与多语言文本对齐至统一语义空间,适用于文本到音乐、图像到音乐检索、零样本分类及音乐推荐等任务。支持27种语言,可扩展至100种,广泛应用于音乐创作、教育、分析及多媒体内容制作。 AI项目与工具 2025年06月12日 86 点赞 0 评论 695 浏览
3D 3D-Speaker是一个多模态开源项目,专注于通过结合声学、语义和视觉信息,实现高精度的说话人识别和语种识别。其主要功能包括说话人日志、说话人识别、语种识别、多模态识别以及重叠说话人检测。项目提供了工业级模型、训练与推理代码,以及多样化数据集,并支持复杂环境下的语音处理任务。应用场景涵盖会议记录、法庭记录、广播制作、电话客服和安全监控等领域。 AI项目与工具 2025年06月12日 29 点赞 0 评论 694 浏览
OpenAI 12天发布会内容全记录,一文快速捕捉亮点信息 OpenAI举办为期12天的系列发布活动,推出包括强化微调技术、Sora视频生成工具、ChatGPT Canvas和高级语音模式在内的多项创新功能,涵盖推理模型、搜索升级和跨平台集成,显著提升AI工具的性能与应用范围。 AI项目与工具 2025年06月12日 61 点赞 0 评论 694 浏览