数据集


ChildMandarin
ChildMandarin是由智源研究院与南开大学合作开发的3-5岁儿童普通话语音数据集,包含41.25小时高质量语音,覆盖全国22个省市。数据通过家长引导式对话采集,保证自然真实。该数据集支持语音识别、说话人验证和语言研究,适用于儿童语言学习、教育系统、智能玩具和语音助手优化等领域,为儿童语音技术研究提供重要资源。
StableCode
StableCode,一个用于代码生成的大语言模型。StableCode 基于 GPT-NeoX 构建,该模型通过指令模型和具体应用示例进行改进,用于解决复杂的编程任务。



DiffSensei
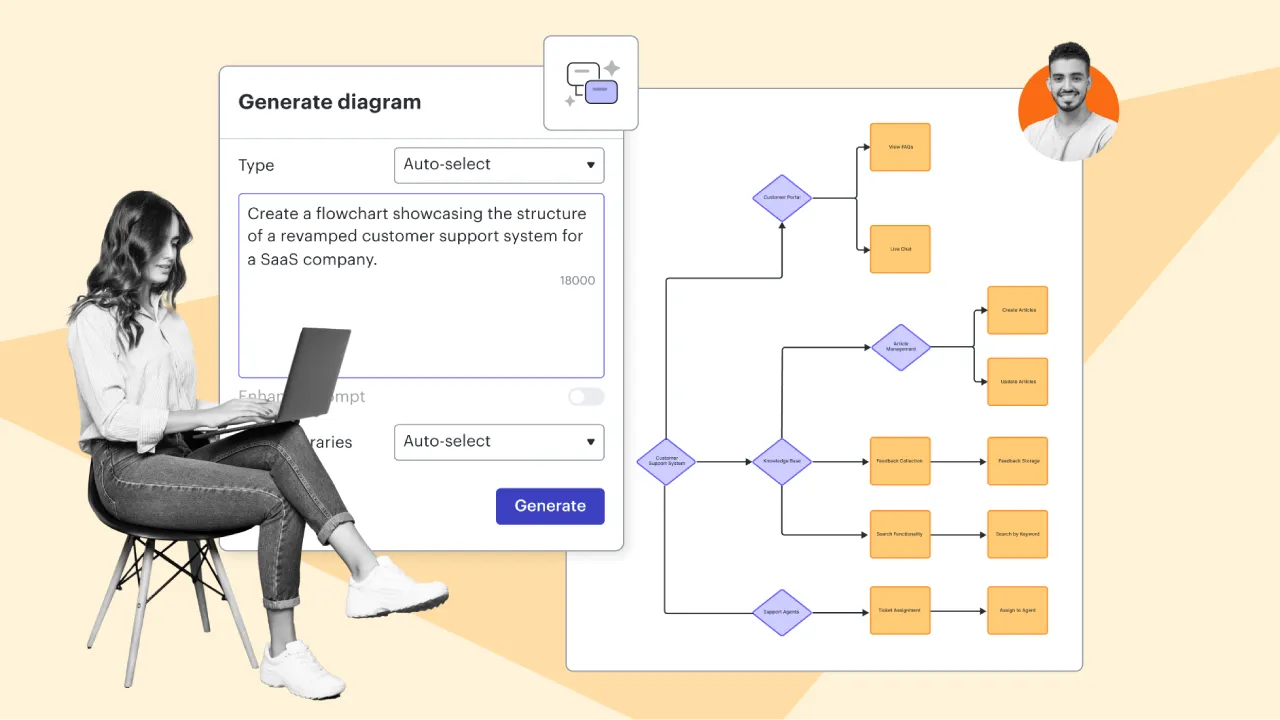
DiffSensei是一款由北京大学、上海AI实验室及南洋理工大学联合开发的漫画生成框架,它结合了基于扩散的图像生成技术和多模态大型语言模型(MLLM)。该工具能够根据用户提供的文本提示和角色图像,生成具有高精度和视觉吸引力的黑白漫画面板,支持多角色场景下的互动与布局调整。其核心技术包括掩码交叉注意力机制、对话布局编码以及MLLM作为特征适配器等,广泛应用于漫画创作、个性化内容生成、教育和培训等领

EvolveDirector
EvolveDirector是一个由阿里巴巴与南洋理工大学合作开发的文本到图像生成框架,通过与高级模型API交互获取数据对,结合预训练的视觉语言模型(VLMs)动态优化训练集,大幅降低数据量和训练成本。该框架支持多模型学习、动态数据集管理及在线训练,显著提升了生成图像的质量和多样性,广泛应用于内容创作、媒体娱乐、广告营销、教育科研等多个领域。

DuoAttention
DuoAttention是由MIT韩松团队提出的新型框架,通过区分“检索头”和“流式头”两种注意力机制,显著提升了大型语言模型在处理长上下文时的推理效率。该框架有效减少了内存占用,加速了解码和预填充过程,并保持了模型的准确性。它适用于多轮对话、长文档处理、学术研究以及内容推荐等多个领域。

