模型

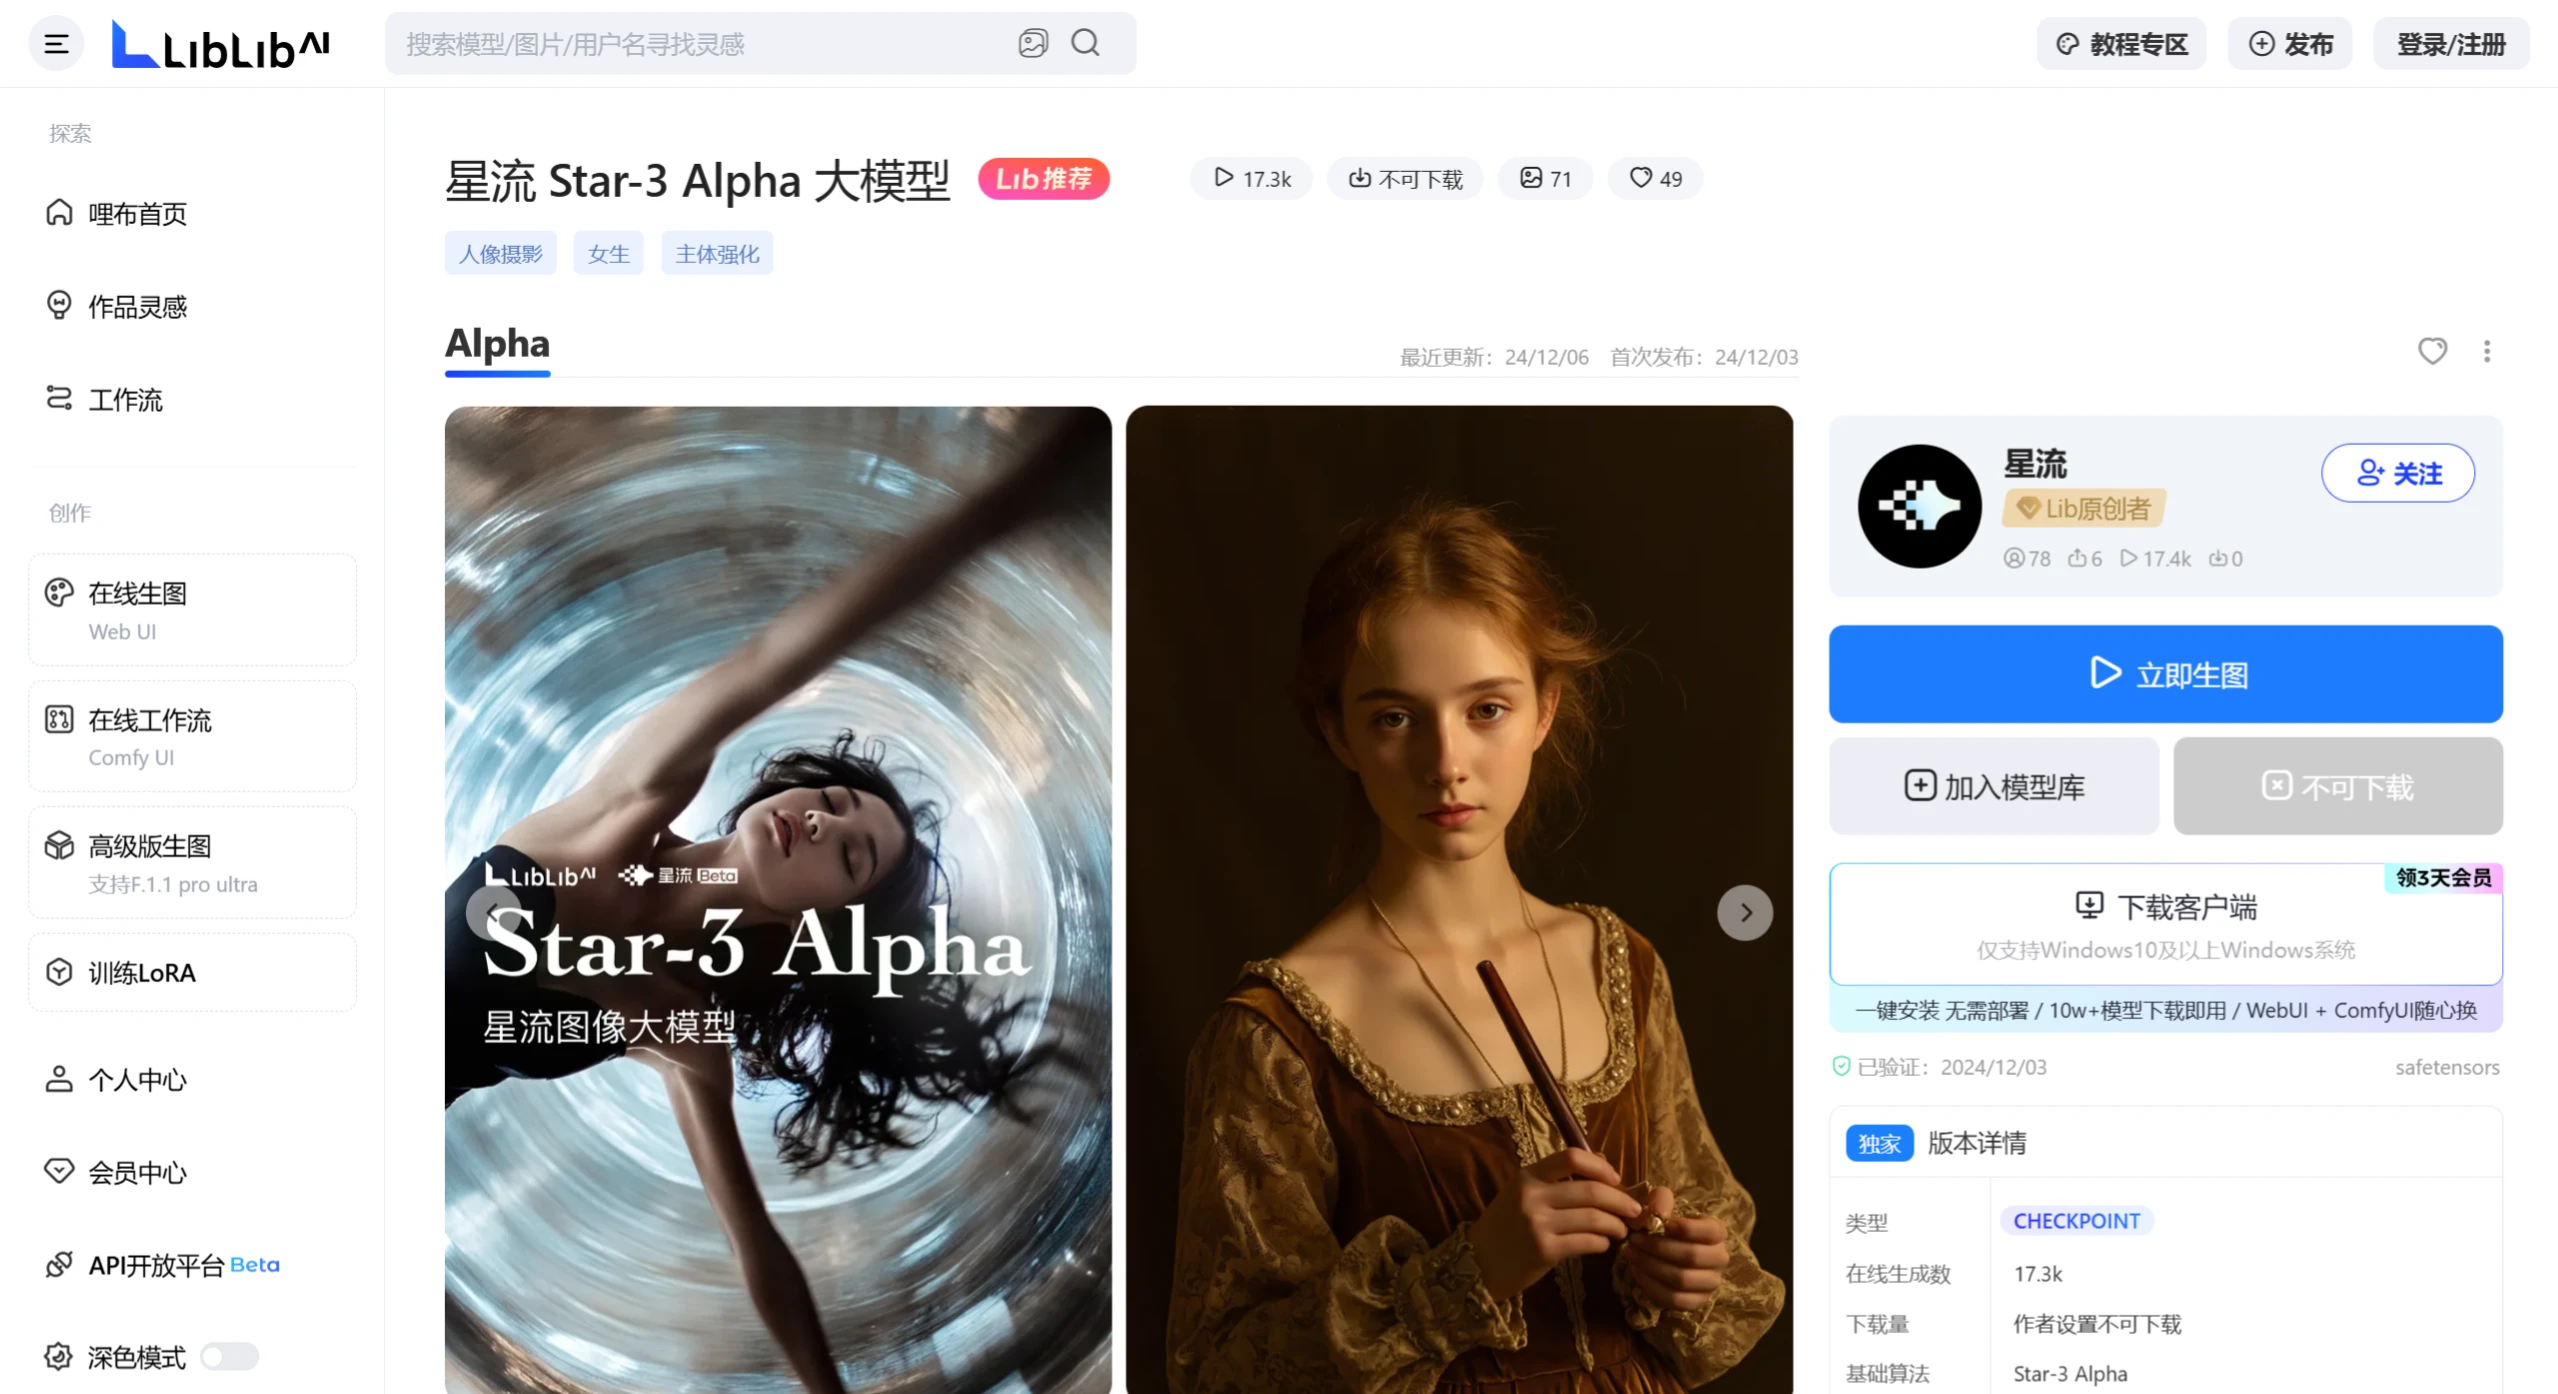
星流图像大模型

星流图像大模型是由LiblibAI发布的一款自研图像大模型,名为Star-3 Alpha。由LiblibAl团队于2024年启动研发,将于2025年Q1发布正式

XVERSE

XVERSE-MoE-A36B是一款由中国元象公司开发的先进MoE(混合专家模型)开源大模型。该模型具备2550亿总参数和360亿激活参数,性能卓越,训练时间缩短30%,推理性能提升100%。它采用前沿的MoE架构,通过稀疏激活、专家网络和门控机制等技术,实现了高效性能和低成本部署。适用于自然语言处理、内容创作、智能客服、教育辅助、信息检索及数据分析等多个领域。

猎户星空大模型

百亿级模型SOTA,支持 32万 tokens 的上下文能够一次性接受并处理约 45 万汉字的输入内容准确提取关键信息。

MagicMan

MagicMan是由多个顶尖研究机构联合开发的AI工具,主要功能是从单张2D图像生成高质量的3D人类模型。它结合了预训练的2D扩散模型和参数化的SMPL-X模型,并通过混合多视角注意力机制和迭代细化策略,实现精确的3D感知和图像生成。MagicMan在游戏、电影、虚拟现实、时尚、零售和教育等多个领域有广泛应用,能够显著提高角色设计的真实感和多样性。

Unique3D

Unique3D是一款由清华大学团队开发的开源框架,专注于单张图像到3D模型的转换。它利用多视图扩散模型和法线扩散模型,结合多级上采样策略和ISOMER算法,能够在短时间内生成高保真度且纹理丰富的3D网格模型。Unique3D能够从单个2D图像生成3D网格模型、多个正交视图图像和法线贴图,并通过多级上采样过程提高图像分辨率,最终实现颜色和几何细节的高度整合。

Orpheus TTS

Orpheus TTS 是一款基于 Llama-3b 架构的开源文本到语音系统,支持自然、富有情感的语音生成。具备零样本语音克隆能力,无需预训练即可模仿特定语音,延迟低至 200 毫秒,适合实时应用。支持多种语音风格和情感控制,适用于有声读物、虚拟助手、游戏、教育等多个领域。

PaliGemma 2

PaliGemma 2是一款由Google DeepMind研发的视觉语言模型(VLM),结合了SigLIP-So400m视觉编码器与Gemma 2语言模型,支持多种分辨率的图像处理。该模型具备强大的知识迁移能力和出色的学术任务表现,在OCR、音乐乐谱识别以及医学图像报告生成等方面实现了技术突破。它能够处理多模态任务,包括图像字幕生成、视觉推理等,并支持量化和CPU推理以提高计算效率。

Magic Data

Magic Data专注于为不同行业的AI模型提供高质量的训练和测试数据,以提升模型的性能和智能。

Rodin

Rodin是一款由影眸科技开发的AI驱动3D生成工具,专注于快速生成高质量的3D模型。它支持文本提示和图片输入生成3D资产,具备多视图融合、模型调整及材质生成等功能,适用于游戏开发、角色建模、虚拟现实等多种场景,同时兼顾生成效率与细节表现,但需进一步优化精度与数据集适应性。

AgentPrune

AgentPrune 是一种针对大型语言模型驱动的多智能体系统的通信优化框架,通过“剪枝”技术减少冗余通信内容,降低通信成本并提升系统性能。其核心技术包括时空图建模、低秩稀疏图掩码和一次性剪枝,可在 AutoGen 和 GPTSwarm 等框架中无缝集成,实现高达 72.8% 的 token 减少。同时具备对抗攻击防御能力,适用于复杂任务协作和工业级应用。