模型

JoyVASA

JoyVASA是一个基于扩散模型的音频驱动数字人头项目,能够生成与音频同步的面部动态和头部运动。其主要功能包括唇形同步、表情控制及动物面部动画生成,支持多语言和跨物种动画化。项目采用两阶段训练方法,结合解耦面部表示与扩散模型技术,生成高质量动画视频,广泛应用于虚拟助手、娱乐媒体、教育、广告等多个领域。

Tripo3D AI

一个由VAST发布的在线3D建模平台,利用先进的AI技术,可以在几秒钟内生成高质量的3D模型。用户可以通过文本描述或上传图片来生成模型。

ILLUME

ILLUME是一款基于大型语言模型的统一多模态大模型,集成了视觉理解与生成能力,采用“连续图像输入 + 离散图像输出”架构,通过语义视觉分词器和三阶段训练流程,实现了高效的数据利用和多模态任务处理能力。模型能够无缝整合视觉理解与生成功能,广泛应用于视频分析、医疗诊断、自动驾驶及艺术创作等领域。

Agent Laboratory

Agent Laboratory是由AMD与约翰·霍普金斯大学合作开发的基于大型语言模型的研究辅助工具,支持从文献综述到报告撰写的全流程科研任务。它具备实验设计、代码生成、结果分析等功能,并通过多代理协作和用户反馈机制提升研究质量。实验表明其可显著降低研究成本,适用于机器学习、生物医学等多个领域。

VITA

VITA-Audio 是一款开源的端到端多模态语音大模型,具备低延迟、高推理效率和多模态交互能力。其核心创新包括轻量级 MCTP 模块和四阶段渐进式训练策略,使模型在语音识别、文本转语音和口语问答等任务中表现优异。支持实时对话、智能客服、教育辅助、医疗辅助及内容创作等多种应用场景,适用于各类语音交互系统。

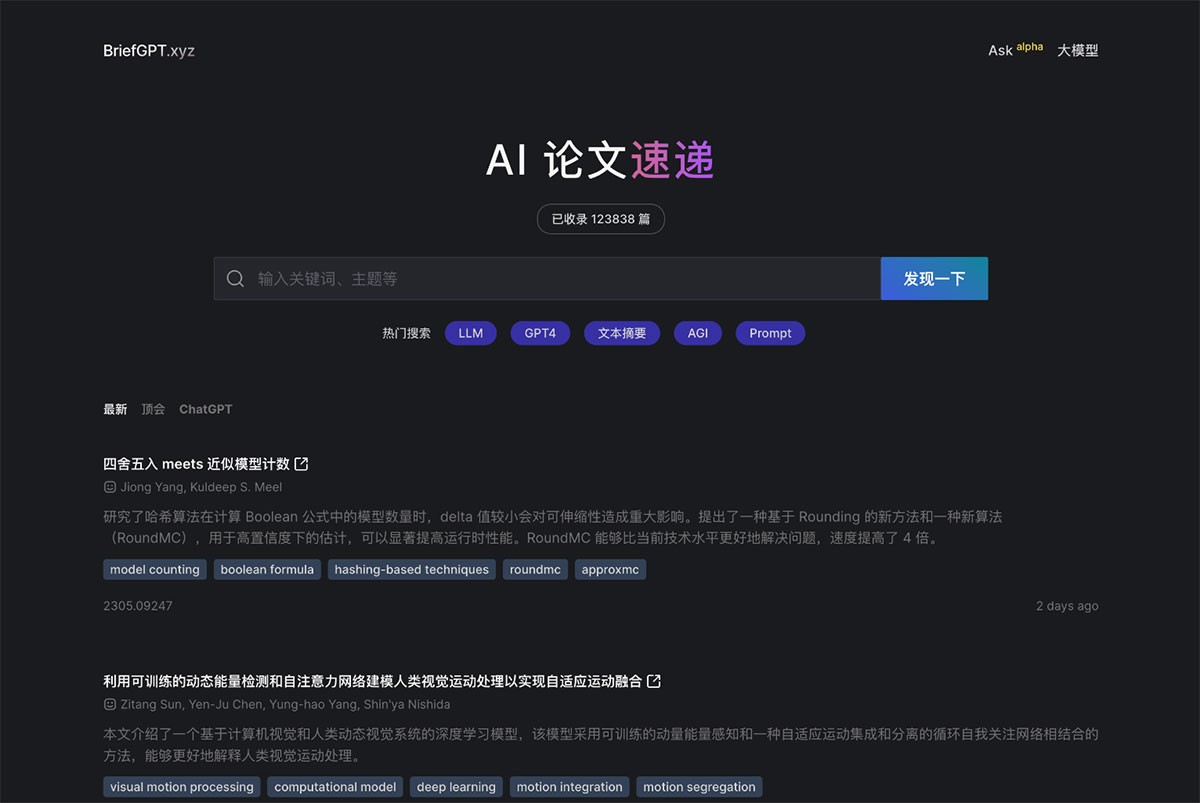
BriefGPT AI论文速递

BriefGPT AI是一个AI论文速递网站,它可以帮助研究人员快速发现AI领域的最新研究进展。BriefGPT AI每天持续更新顶级会议和期刊上发表的AI相关论文,并提供论文标题、简要摘要以及论文PDF下载链接。

ChatTTSPlus

ChatTTSPlus 是一款基于深度学习的语音合成工具,它通过 TensorRT 技术实现了显著的性能提升,同时支持语音克隆、模型压缩与加速等功能。该工具不仅适用于桌面端,还能够部署于移动设备,满足多种应用场景需求,包括有声读物制作、语言学习辅助、客户服务及娱乐等领域。 ---

DreamGen

DreamGen是英伟达推出的机器人学习技术,基于AI视频世界模型生成合成数据,使机器人能在梦境中学习新技能。它通过微调视频世界模型、生成虚拟数据、提取虚拟动作和训练下游策略四步流程,实现机器人在新环境中的行为和环境泛化。DreamGen无需大量真实数据,仅凭文本指令即可完成复杂任务,提升学习效率和泛化能力。其支持多种机器人系统和策略架构,适用于工业生产、家庭服务、医疗护理等多个领域。

braintrust

Braintrust 是一个端到端的 AI 工具平台,专注于通过迭代式的工作流帮助公司快速构建高效的 AI 应用。它提供了强大的提示调整、评分器配置及数据集管理功能,支持从模型评估到质量控制的全流程优化。此外,Braintrust 的直观界面和代码库集成特性使其适用于各类用户群体,广泛应用于 AI 产品开发、模型评估、质量控制及数据集构建等领域。