虚拟

EMO2

EMO2是一种由阿里巴巴智能计算研究院开发的音频驱动头像视频生成技术,通过音频输入和静态人像照片生成高质量、富有表现力的动态视频。其核心技术包括音频与手部动作的协同建模、扩散模型生成视频帧,以及高精度音频同步。该工具支持多样化动作生成,适用于虚拟现实、动画制作和跨语言内容创作等场景,具备自然流畅的视觉效果和丰富的应用场景。

BuzzClip

BuzzClip 是一款基于人工智能的视频生成工具,专注于帮助用户在短时间内高效制作适合 TikTok 等平台的短视频内容。平台提供超过 100 个 AI 虚拟形象、多种预设模板及多语言支持,适用于品牌推广、产品展示和社交媒体运营等多种场景。用户可直接发布视频并进行品牌定制,具备完整的商业使用权和基础数据分析功能,提升内容创作效率与传播效果。

ObjectMover

ObjectMover是由香港大学与Adobe Research联合开发的图像编辑模型,专注于解决物体移动、插入和移除过程中的光影协调问题。通过视频先验迁移和序列到序列建模技术,实现对光照、阴影和遮挡关系的精准控制。支持多任务学习,提升模型在真实场景中的适应性。广泛应用于特效制作、虚拟场景编辑、游戏开发等领域,具备高效、真实的图像编辑能力。

DeepMesh

DeepMesh是由清华大学和南洋理工大学研发的3D网格生成框架,结合强化学习与自回归变换器技术,实现高质量、高精度的3D模型生成。支持点云和图像条件输入,具备高效的预训练策略与人类偏好对齐机制,适用于虚拟环境、角色动画、医学模拟及工业设计等多个领域。

Aiuni

[Aiuni是一款利用先进AI技术将2D图像转化为高质量3D模型的在线平台。它支持纹理生成、模型优化、动画添加等功能,适用于数字媒体、游戏开发、影视制作等多个行业。其核心技术包括多视图扩散模型和网格重建算法,能快速生成高保真度的3D模型,并具备强大的细节捕捉能力。]

Glow

GLOW 是一个创新的AI虚拟社交应用,它通过提供个性化的智能体和沉浸式的交流体验,使用户能够与AI建立情感联系,享受不间断的社交互动。

DreamO

DreamO是由字节跳动与北京大学联合开发的图像定制生成框架,基于扩散变换器(DiT)模型实现多条件图像生成。支持身份、风格、背景等条件的灵活集成,具备高质量生成、条件解耦和精准控制能力。适用于虚拟试穿、风格迁移、主体驱动生成等多种场景,具备广泛的适用性和技术先进性。

MVGenMaster

MVGenMaster是一款基于多视图扩散模型的工具,利用增强的3D先验技术实现新视角合成任务。它可以从单一图像生成多达100个新视图,具有高度的灵活性和泛化能力。模型结合了度量深度、相机姿态扭曲以及全注意力机制等技术,支持高效的前向传播过程,同时兼容大规模数据集。MVGenMaster在视频游戏、电影特效、虚拟现实、3D建模及建筑可视化等领域具有广泛应用前景。
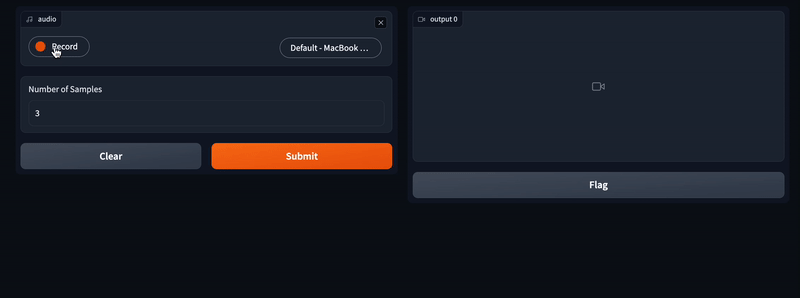
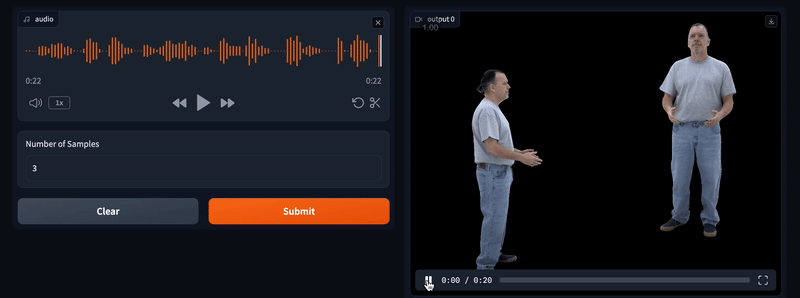
Audio2Photoreal

从音频生成全身逼真的虚拟人物形象。它可以从多人对话中语音中生成与对话相对应的逼真面部表情、完整身体和手势动作。

Yodayo AI | 文本生成动漫图片

Yodayo是一个AI文本生成动漫图片工具,是一款先进的人工智能系统,它可以根据你输入的文字或图片,自动生成出免费、高质量的动漫风格的画面。