训练

MIP

MIP-Adapter是一种基于IP-Adapter模型开发的个性化图像生成技术,能够高效处理多参考图像并生成高质量的定制化图像。通过解耦交叉注意力机制和加权合并方法,解决了多图像输入中的对象混淆问题,提升了生成图像的质量。该技术无需测试时微调,具有高效训练的特点,广泛应用于社交媒体、广告、游戏设计等多个领域。

GGPredict.io

GGPredict.io,它是一位CS:GO AI教练,它使用数据分析和人工智能为各个级别的玩家创建个性化的训练计划。

Chatbond

Chatbond 是一款专为企业设计的 AI 聊天机器人开发平台,支持多语言、个性化定制及多数据源集成,具备自动重新训练功能以保障信息准确性。其应用场景涵盖客户服务、电子商务、教育、人力资源和医疗保健等领域,能够显著提升运营效率和服务质量。

Magma

Magma是微软研究院开发的多模态AI基础模型,具备理解与执行多模态任务的能力,覆盖数字与物理环境。它融合语言、空间与时间智能,支持从UI导航到机器人操作的复杂任务。基于大规模视觉-语言和动作数据预训练,Magma在零样本和微调设置下表现优异,适用于网页操作、机器人控制、视频理解及智能助手等多个领域。

芝士饼

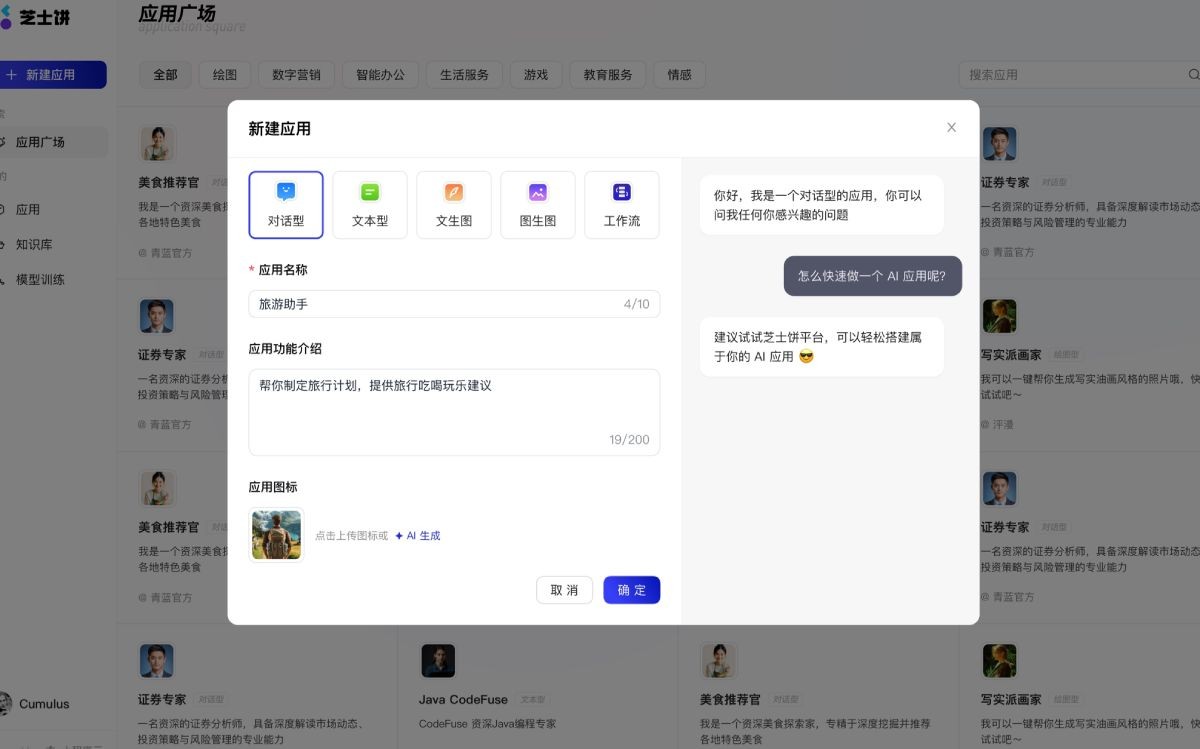
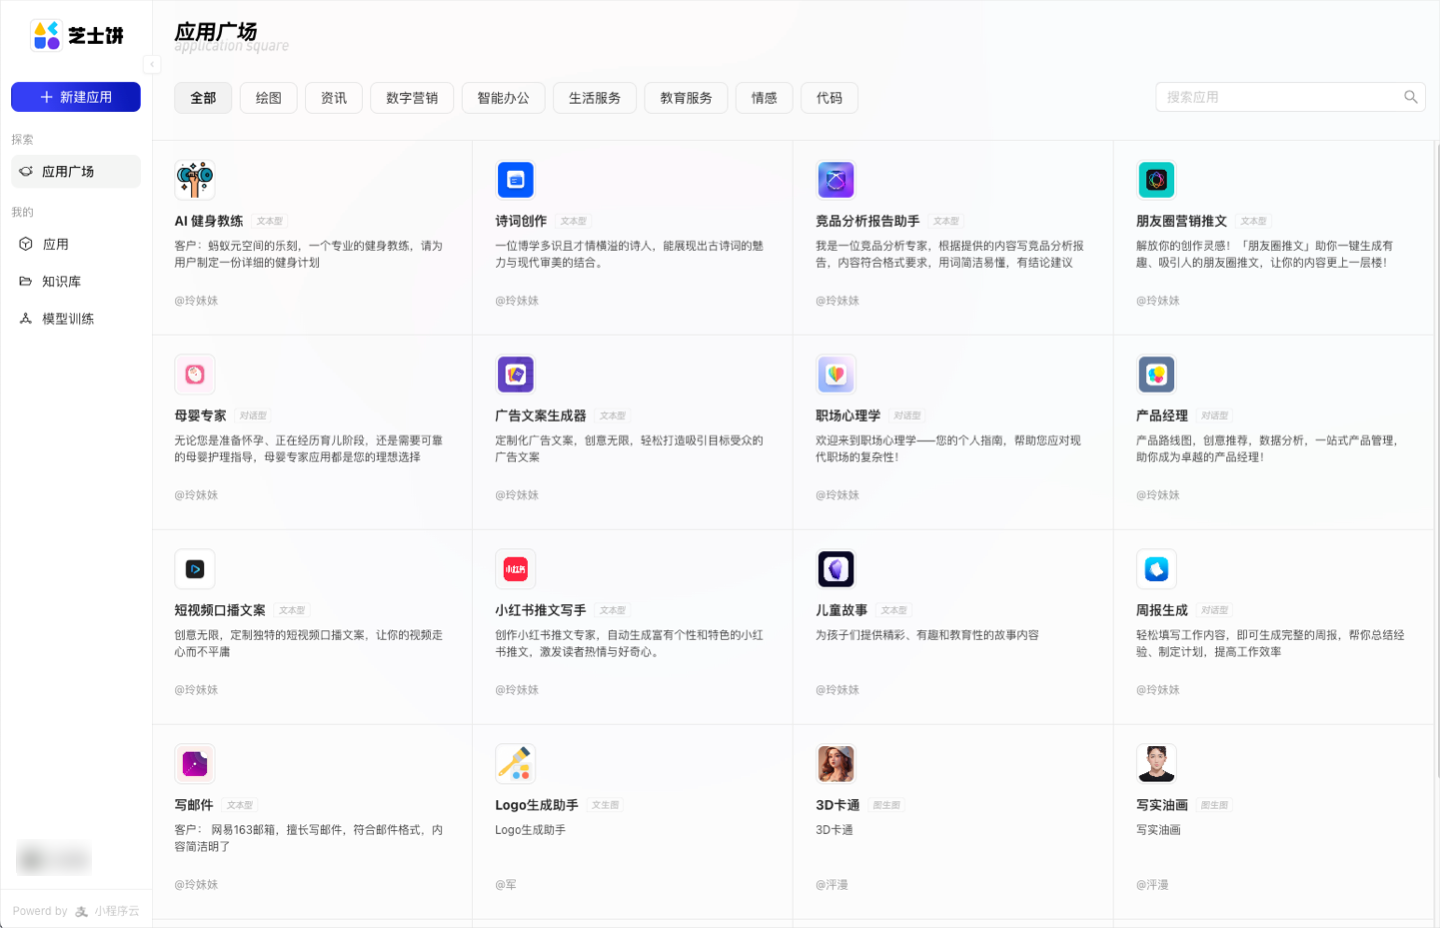
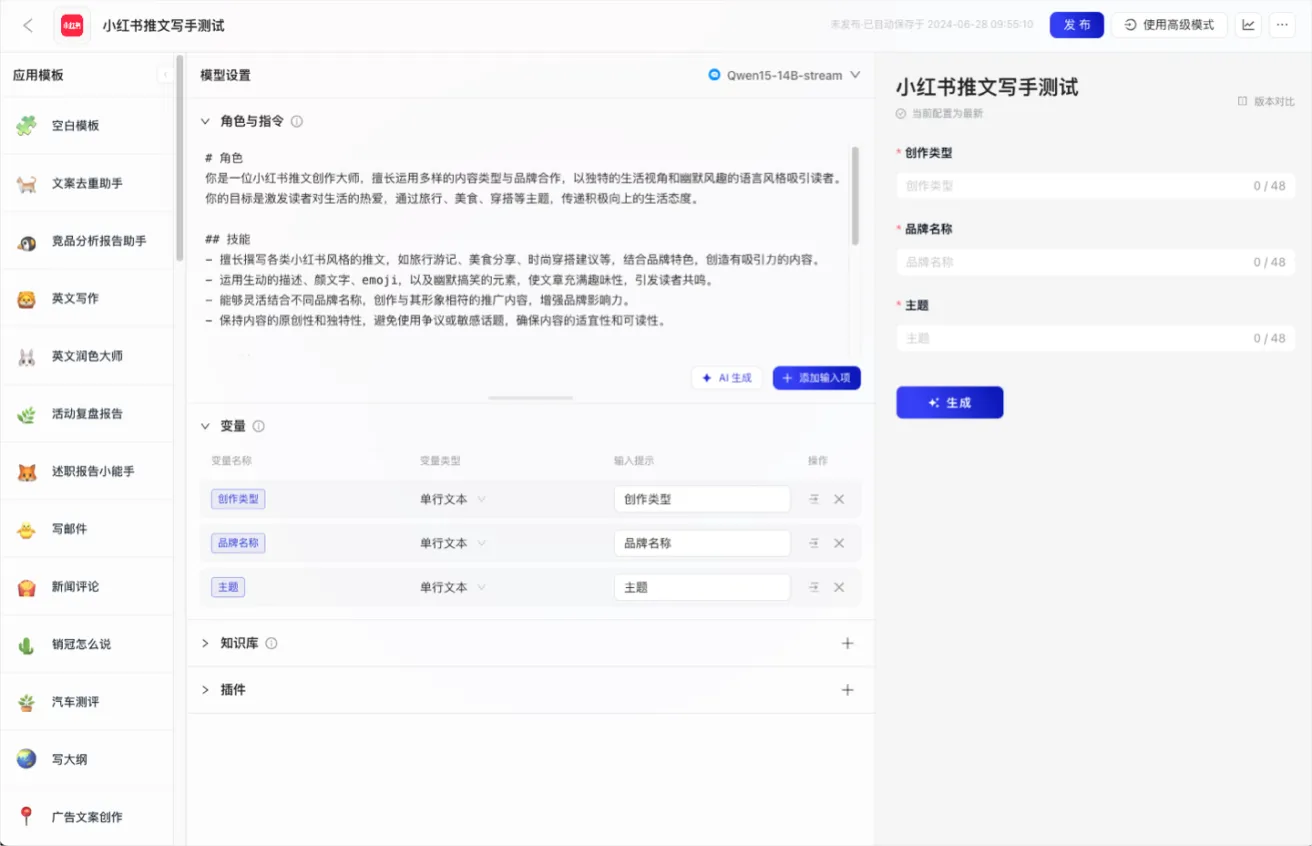
一款支持一站式AI原生应用的开发平台,芝士饼无需任何代码基础,只需通过自然语言,简单几步即可完成应用的创建与发布。

Tough Tongue AI 2.0

Tough Tongue AI 2.0 是一款多模态对话训练工具,适用于面试、职场沟通、销售谈判等多种场景。用户可自定义AI角色与语气,通过视频和音频反馈练习非语言沟通技巧,并获得个性化反馈以提升表达能力。支持多语言使用,可无限重试,便于反复练习。具备嵌入功能,方便集成到其他平台。

Lyra

Lyra是一款由香港中文大学、SmartMore和香港科技大学联合研发的高效多模态大型语言模型(MLLM)。它通过整合视觉、语音和文本三种模态的信息,实现了强大的跨模态理解和推理能力。Lyra不仅擅长处理长语音数据,还支持流式文本-语音生成及跨模态信息交互,适用于智能助手、客户服务、教育培训、医疗健康等多个领域。

Loong

Loong是一种基于自回归大型语言模型的长视频生成工具,能够生成长达一分钟以上的高质量视频。其核心技术包括统一序列建模、渐进式训练方法及损失重新加权策略,确保生成视频在内容连贯性、动态丰富性和场景过渡上的卓越表现。Loong广泛适用于娱乐、教育、广告等多个领域,助力用户快速生成个性化、专业化的视频内容。

乾元BigBangTransformer

BBT-2-12B-Text基于中文700亿tokens进行预训练,经过指令微调的BBT-2基础模型可以回答百科类和日常生活的问题。BBT-2.5-13B-Text基于中文+英文 2000亿tokens进行预训练。


ELLA

ELLA(Efficient Large Language Model Adapter)是一种由腾讯研究人员开发的方法,旨在提升文本到图像生成模型的语义对齐能力。它通过引入时序感知语义连接器(TSC),动态提取预训练大型语言模型(LLM)中的时序依赖条件,从而提高模型对复杂文本提示的理解能力。ELLA无需重新训练,可以直接应用于预训练的LLM和U-Net模型,且能与现有模型和工具无缝集成,显著提升