WorldSense WorldSense是由小红书与上海交通大学联合开发的多模态基准测试工具,用于评估大型语言模型在现实场景中对视频、音频和文本的综合理解能力。该平台包含1662个同步视频、3172个问答对,覆盖8大领域及26类认知任务,强调音频与视频信息的紧密耦合。所有数据经专家标注并多重验证,确保准确性。适用于自动驾驶、智能教育、监控、客服及内容创作等多个领域,推动AI模型在多模态场景下的性能提升。 AI项目与工具 2025年06月12日 61 点赞 0 评论 824 浏览
TTS TTS语音向导是一种工具,允许用户通过微软Azure语音识别和TTS将语音转换为文本,然后再转换回语音。它还向VRChat发送OSC消息以在头像上显示文本。该工具有许多自定义选项,包括100... Ai语音工具 2026年11月07日 0 点赞 0 评论 819 浏览
UniFab 一款功能强大的视频增强工具,UniFab具有AI驱动的升频、降噪、SDR 到 HDR 转换以及其他多种功能,提升视频质量,满足专业人士和爱好者的需求。 视频剪辑 2025年06月05日 21 点赞 0 评论 817 浏览
CoGenAV CoGenAV是一种先进的多模态学习模型,专注于音频和视觉信号的对齐与融合。通过对比特征对齐和生成文本预测的双重目标进行训练,利用同步音频、视频和文本数据,学习捕捉时间对应关系和语义信息。CoGenAV具备音频视觉语音识别、视觉语音识别、噪声环境下的语音处理、语音重建与增强、主动说话人检测等功能,适用于智能助手、视频内容分析、工业应用和医疗健康等多个场景。 AI项目与工具 2025年06月11日 80 点赞 0 评论 817 浏览
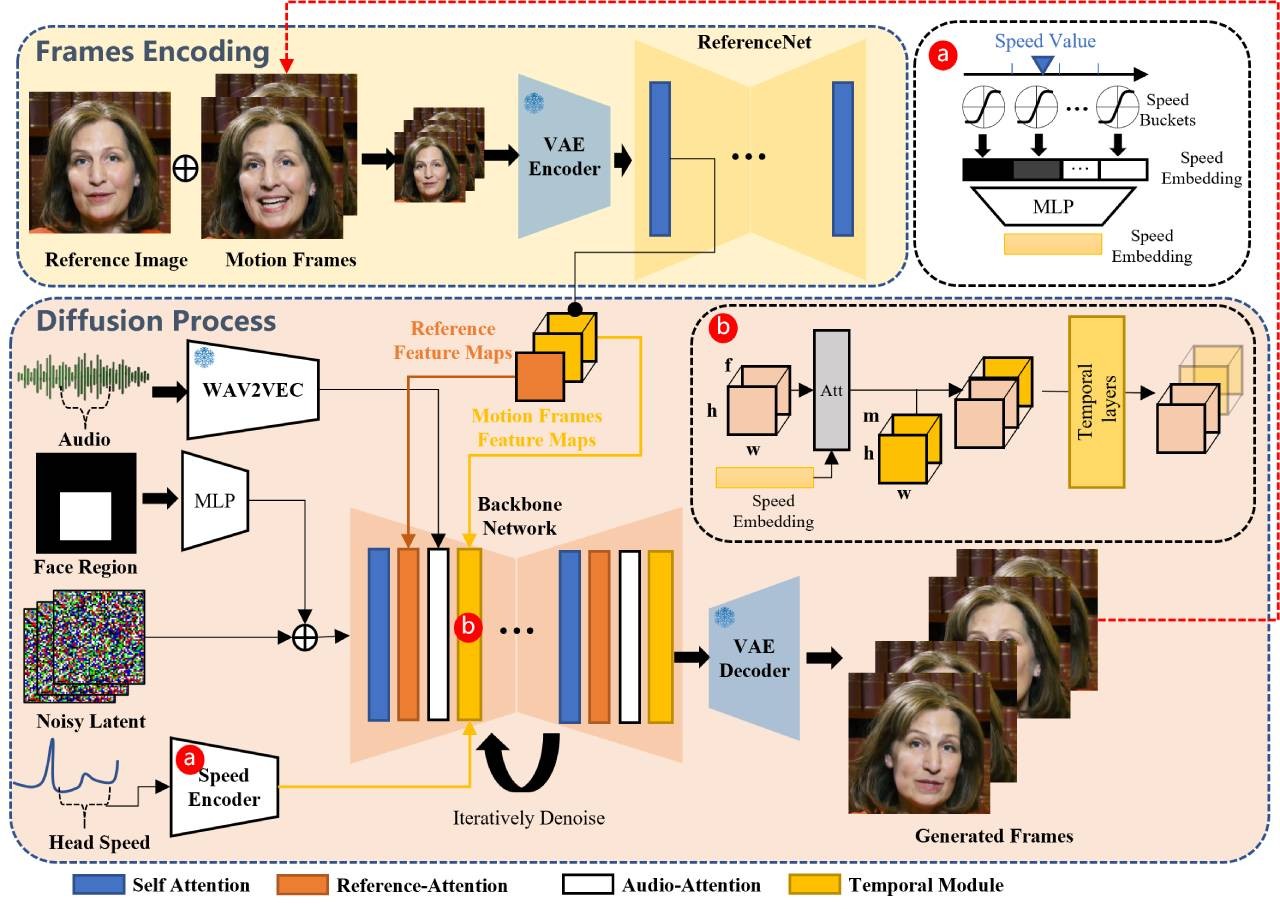
Emote Portrait Alive 阿里巴巴发布的EMO,一种音频驱动的AI肖像视频生成框架。通过输入单一的参考图像和语音音频,Emote Portrait Alive可以生成动态的、表情丰富的肖像视频。 Ai开源项目 2025年06月05日 18 点赞 0 评论 816 浏览
Azure AI Azure AI 语音服务为用户提供了一套全面的语音处理解决方案,支持多种语言,具备高度的自定义能力,适用于各种规模的公司和多样化的应用场景。 创作工具 2026年11月07日 0 点赞 0 评论 815 浏览
Synthesizer V Synthesizer V是一款革命性的音乐制作工具,它使用基于深度神经网络的合成引擎来生成令人难以置信的逼真的歌声。它具有可定制的AI音高生成,无限音轨,无核心限制,VST3/AU插件支... Ai语音工具 2026年11月07日 0 点赞 0 评论 814 浏览
MimicTalk MimicTalk是一款利用NeRF技术快速生成个性化3D说话人脸模型的工具,其核心功能包括15分钟内完成新身份训练、高质量视频生成、增强的表现力以及上下文学习能力。该工具通过混合适应流程、上下文风格化音频到运动模型等技术,实现了高效的数据样本利用和训练效率提升,适用于虚拟主播、远程协作、VR/AR等领域。 AI项目与工具 2025年06月12日 59 点赞 0 评论 814 浏览