AI语音

EmotiVoice

EmotiVoice是网易有道推出的开源文本到语音系统,支持中英文及2000+音色,能根据提示生成带情感的语音。具备情感合成、语音克隆、多语言支持等功能,提供Web界面和API接口,适用于有声读物、智能助手、教育、客服等场景,技术上支持高效部署与模型微调。

Eleven Labs

Eleven Labs的长格式语音生成平台使用人工智能为创作者和出版商创造自然而引人注目的声音。

Vid.AI

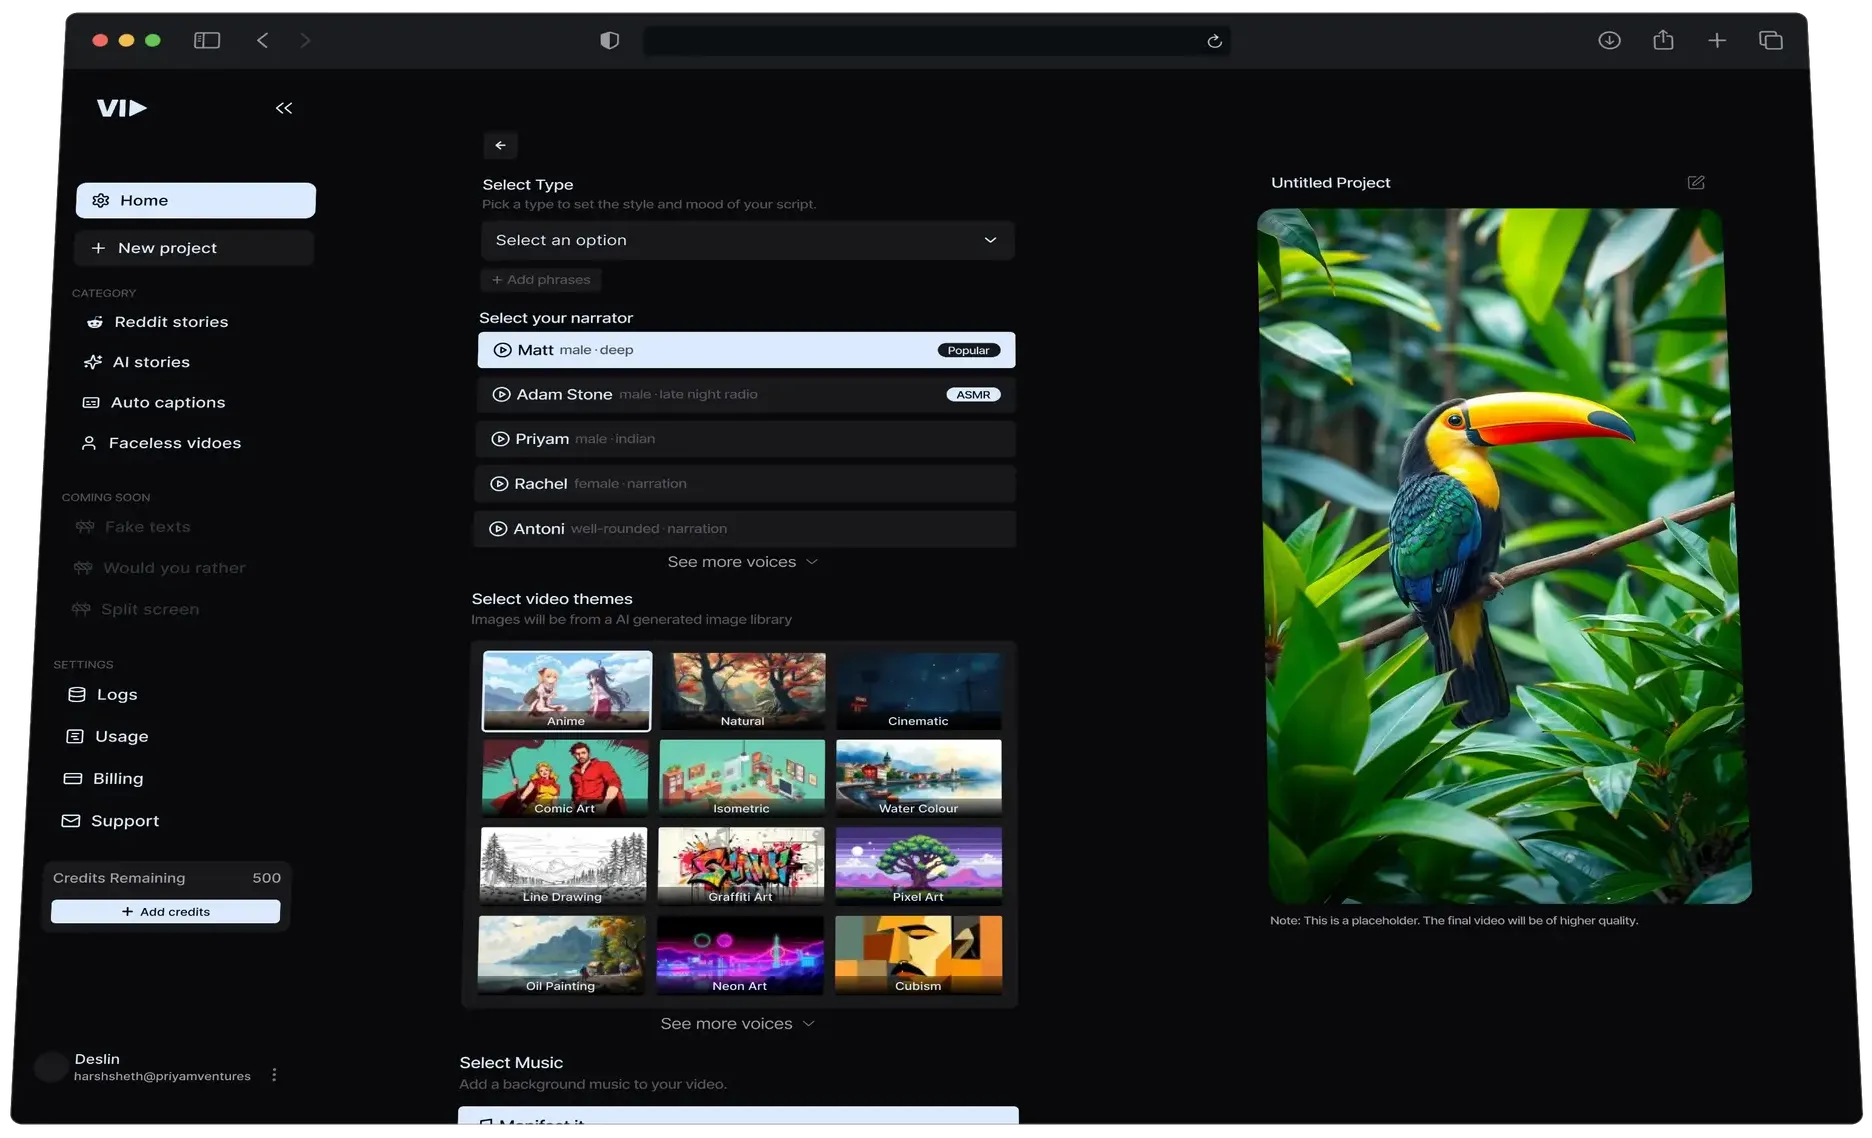
一个爆款短视频生成AI工具并优化这些视频以提高在社交媒体上的传播率,提供提示生成视频、AI 脚本生成、AI 声音、短视频创作和内置的素材库。

Voice Engine

Voice Engine是由OpenAI开发的AI语音合成和声音克隆技术。该技术能够通过15秒的音频样本和文本输入生成自然语音。它已在OpenAI的文本到语音API和ChatGPT的语音功能中应用。Voice Engine广泛应用于教育、翻译、远程服务提供、支持言语残障者以及帮助恢复患者声音等方面。为了确保技术安全,OpenAI实施了严格的使用政策和安全措施。

Voicebox

Voicebox 是由 Meta AI 研究团队开发的一款领先的语音生成模型。Voicebox 能够在六种语言中合成语音,消除瞬态噪声,编辑内容,在语言之间转移音频风格,并生成多样的语音样本。此...

Parakeet TDT 0.6B

Parakeet TDT 0.6B 是一款由英伟达开发的开源自动语音识别(ASR)模型,采用 FastConformer 和 TDT 架构,具备高速转录、高精度识别、歌词转录、文本格式化等功能。模型在 Hugging Face Open ASR Leaderboard 中表现优异,实时因子高达 3386,适用于会议记录、法律医疗、字幕生成及音乐索引等多种场景。

Uberduck

Uberduck是一个开源的语音AI社区,可以帮助用户在几分钟内通过api创建人工智能生成的音频应用程序。它允许用户使用5000 +富有表现力的声音制作AI画外音,并使用他们的AI生成的说唱...

Subtitle Edit

Subtitle Edit 是一款免费开源的多功能字幕编辑器,支持超过300种字幕格式。它具备字幕同步、创建、翻译、音频波形可视化、视频播放、AI语音识别、AI自动翻译和OCR技术等功能,适用于影视后期、多语言内容创作、教育培训及辅助听力障碍者等场景。其界面友好,操作简便。

FireRedASR

FireRedASR是小红书推出的工业级自动语音识别(ASR)模型系列,支持普通话、中文方言和英语,具备高精度和高效推理能力。其包含FireRedASR-LLM和FireRedASR-AED两个版本,分别聚焦于极致精度和计算效率。模型在多个场景如智能助手、视频字幕生成、歌词识别和语音输入中表现出色,且已开源,推动语音识别技术的发展。

EVI 3

EVI 3是Hume AI推出的全新语音语言模型,能够同时处理文本和语音标记,实现自然、富有表现力的语音交互。它支持高度个性化,根据用户提示生成任何声音和个性,并实时调节情感和说话风格。在与GPT-4o等模型的对比中,EVI 3在情感理解、表现力、自然度和响应速度等方面表现更优,具备低延迟响应能力,可在300毫秒内生成语音回答。EVI 3适用于智能客服、语音助手、教育辅导、情感支持和内容创作等多个