AI

iA Presenter

iA Presenter 的文本界面将焦点放在故事上,节省时间和精力。

Bright Eye

Bright Eye是一款多功能的AI分析图像,可以生成文本、图像、代码、故事、诗歌的APP程序。

Visla

Visla的AI视频生成器为用户提供了一个强大的工具,可以轻松地将各种内容转换成视频,无需专业的视频编辑技能。

Lambda Finance.ai

Lambda Finance.ai 是一款基于AI的投资组合管理工具,提供投资组合分析、资产配置、股息管理、风险评估和回报分析等功能。用户可通过AI聊天机器人获得个性化建议,系统支持资产分类、多元化检查、风险预警及历史数据预测,帮助用户优化投资策略并提升收益。
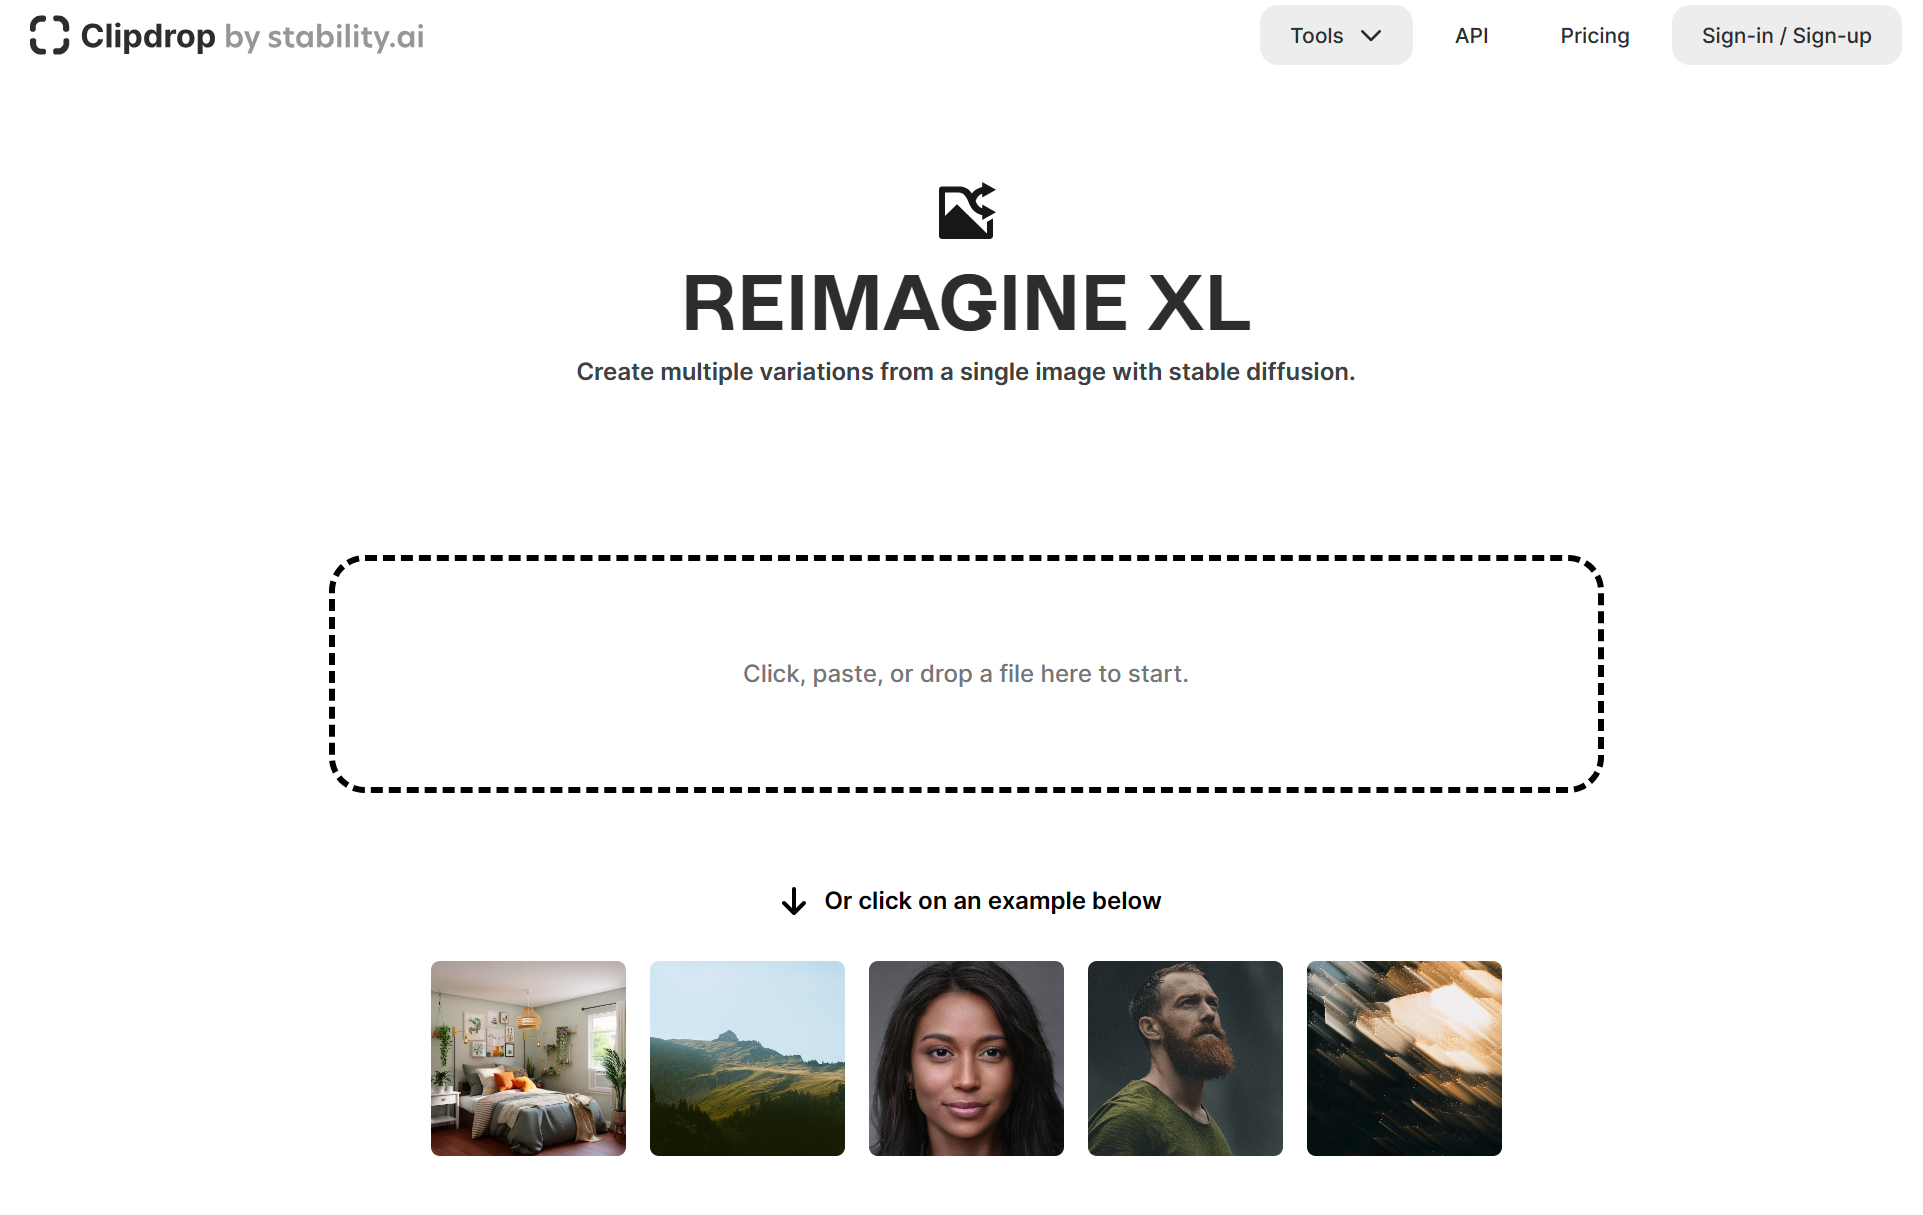
Stable Diffusion Reimagine

Stable Diffusion Reimagine,简称SD-R是一款新的Clipdrop工具,允许用户无限制地生成单张图片的多种变化。

Llama 3

Llama 3是Meta公司开发的一款最新大型语言模型,提供了8B和70B两种参数规模的模型。它通过增加参数规模、扩大训练数据集、优化模型架构和增强安全性等功能,显著提升了自然语言处理能力,适用于编程、问题解决、翻译和对话生成等多种应用场景。Llama 3在多个基准测试中表现出色,并且通过指令微调进一步增强了特定任务的表现。

voice.ai

voice.ai的使命是通过普及人工智能技术,增强协作创造力,并允许社区重新定义音频表达方式。公司相信人工智能应该是易于接近、对所有人开放且富有趣味的。

Avat3r

Avat3r 是由慕尼黑工业大学与 Meta Reality Labs 联合开发的高保真三维头部头像生成模型,基于高斯重建技术,仅需少量输入图像即可生成高质量且可动画化的 3D 头像。其核心优势在于使用交叉注意力机制实现表情动态化,支持多源输入,具备良好的鲁棒性和泛化能力。适用于 VR/AR、影视制作、游戏开发及数字人等领域。

OpenAudio S1

OpenAudio S1是Fish Audio推出的文本转语音(TTS)模型,基于200万小时音频数据训练,支持13种语言。采用双自回归架构和RLHF技术,生成自然流畅的语音,支持50多种情感和语调标记。具备零样本和少样本语音克隆功能,仅需10到30秒音频即可生成高保真声音。适用于视频配音、播客、游戏角色语音、虚拟助手、游戏娱乐、教育培训及客服系统等场景。提供40亿参数完整版和5亿参数开源版,满足

moonshot

moonshot-v1-vision-preview 是一款由月之暗面开发的多模态图像理解模型,具备精准的图像识别、OCR 文字识别和数据解析能力。支持 API 集成,适用于内容审核、文档处理、医学分析、智能交互等多个领域。模型可识别复杂图像细节、分析图表数据,并从美学角度进行图像评价,适合需要高效图像处理和智能交互的应用场景。